AI Agent
Agent Skills 与 MCP:智能体能力扩展的两种范式
引言:MCP 之后,我们还需要什么?
在第十章中,我们深入探讨了 MCP(Model Context Protocol)如何通过标准化协议解决智能体与外部工具的连接问题。你已经学会了如何让智能体通过 MCP 访问数据库、文件系统、API 服务等各种资源。让我们回顾一个典型的 MCP 使用场景:
from hello_agents import ReActAgent, HelloAgentsLLM
from hello_agents.tools import MCPTool
llm = HelloAgentsLLM()
agent = ReActAgent(name="数据分析助手", llm=llm)
# 连接到数据库 MCP 服务器
db_mcp = MCPTool(server_command=["python", "database_mcp_server.py"])
agent.add_tool(db_mcp)
# 智能体现在可以访问数据库了
response = agent.run("查询员工表中薪资最高的前10名员工")
这段代码工作得很好,智能体成功连接到了数据库。但当你尝试处理更复杂的任务时,会发现一些微妙的问题:
# 一个更复杂的需求
response = agent.run("""
分析公司内部谁的话语权最高?
需要综合考虑:
1. 管理层级和下属数量
2. 薪资水平和涨薪幅度
3. 任职时长和稳定性
4. 跨部门影响力
""")
这个任务需要执行多次数据库查询,每次查询的结果会影响下一次查询的策略。更关键的是,它需要智能体具备领域知识:知道如何衡量"话语权",知道应该从哪些维度分析数据,知道如何组合多个查询结果得出结论。
此时,你会遇到两个根本性的问题:
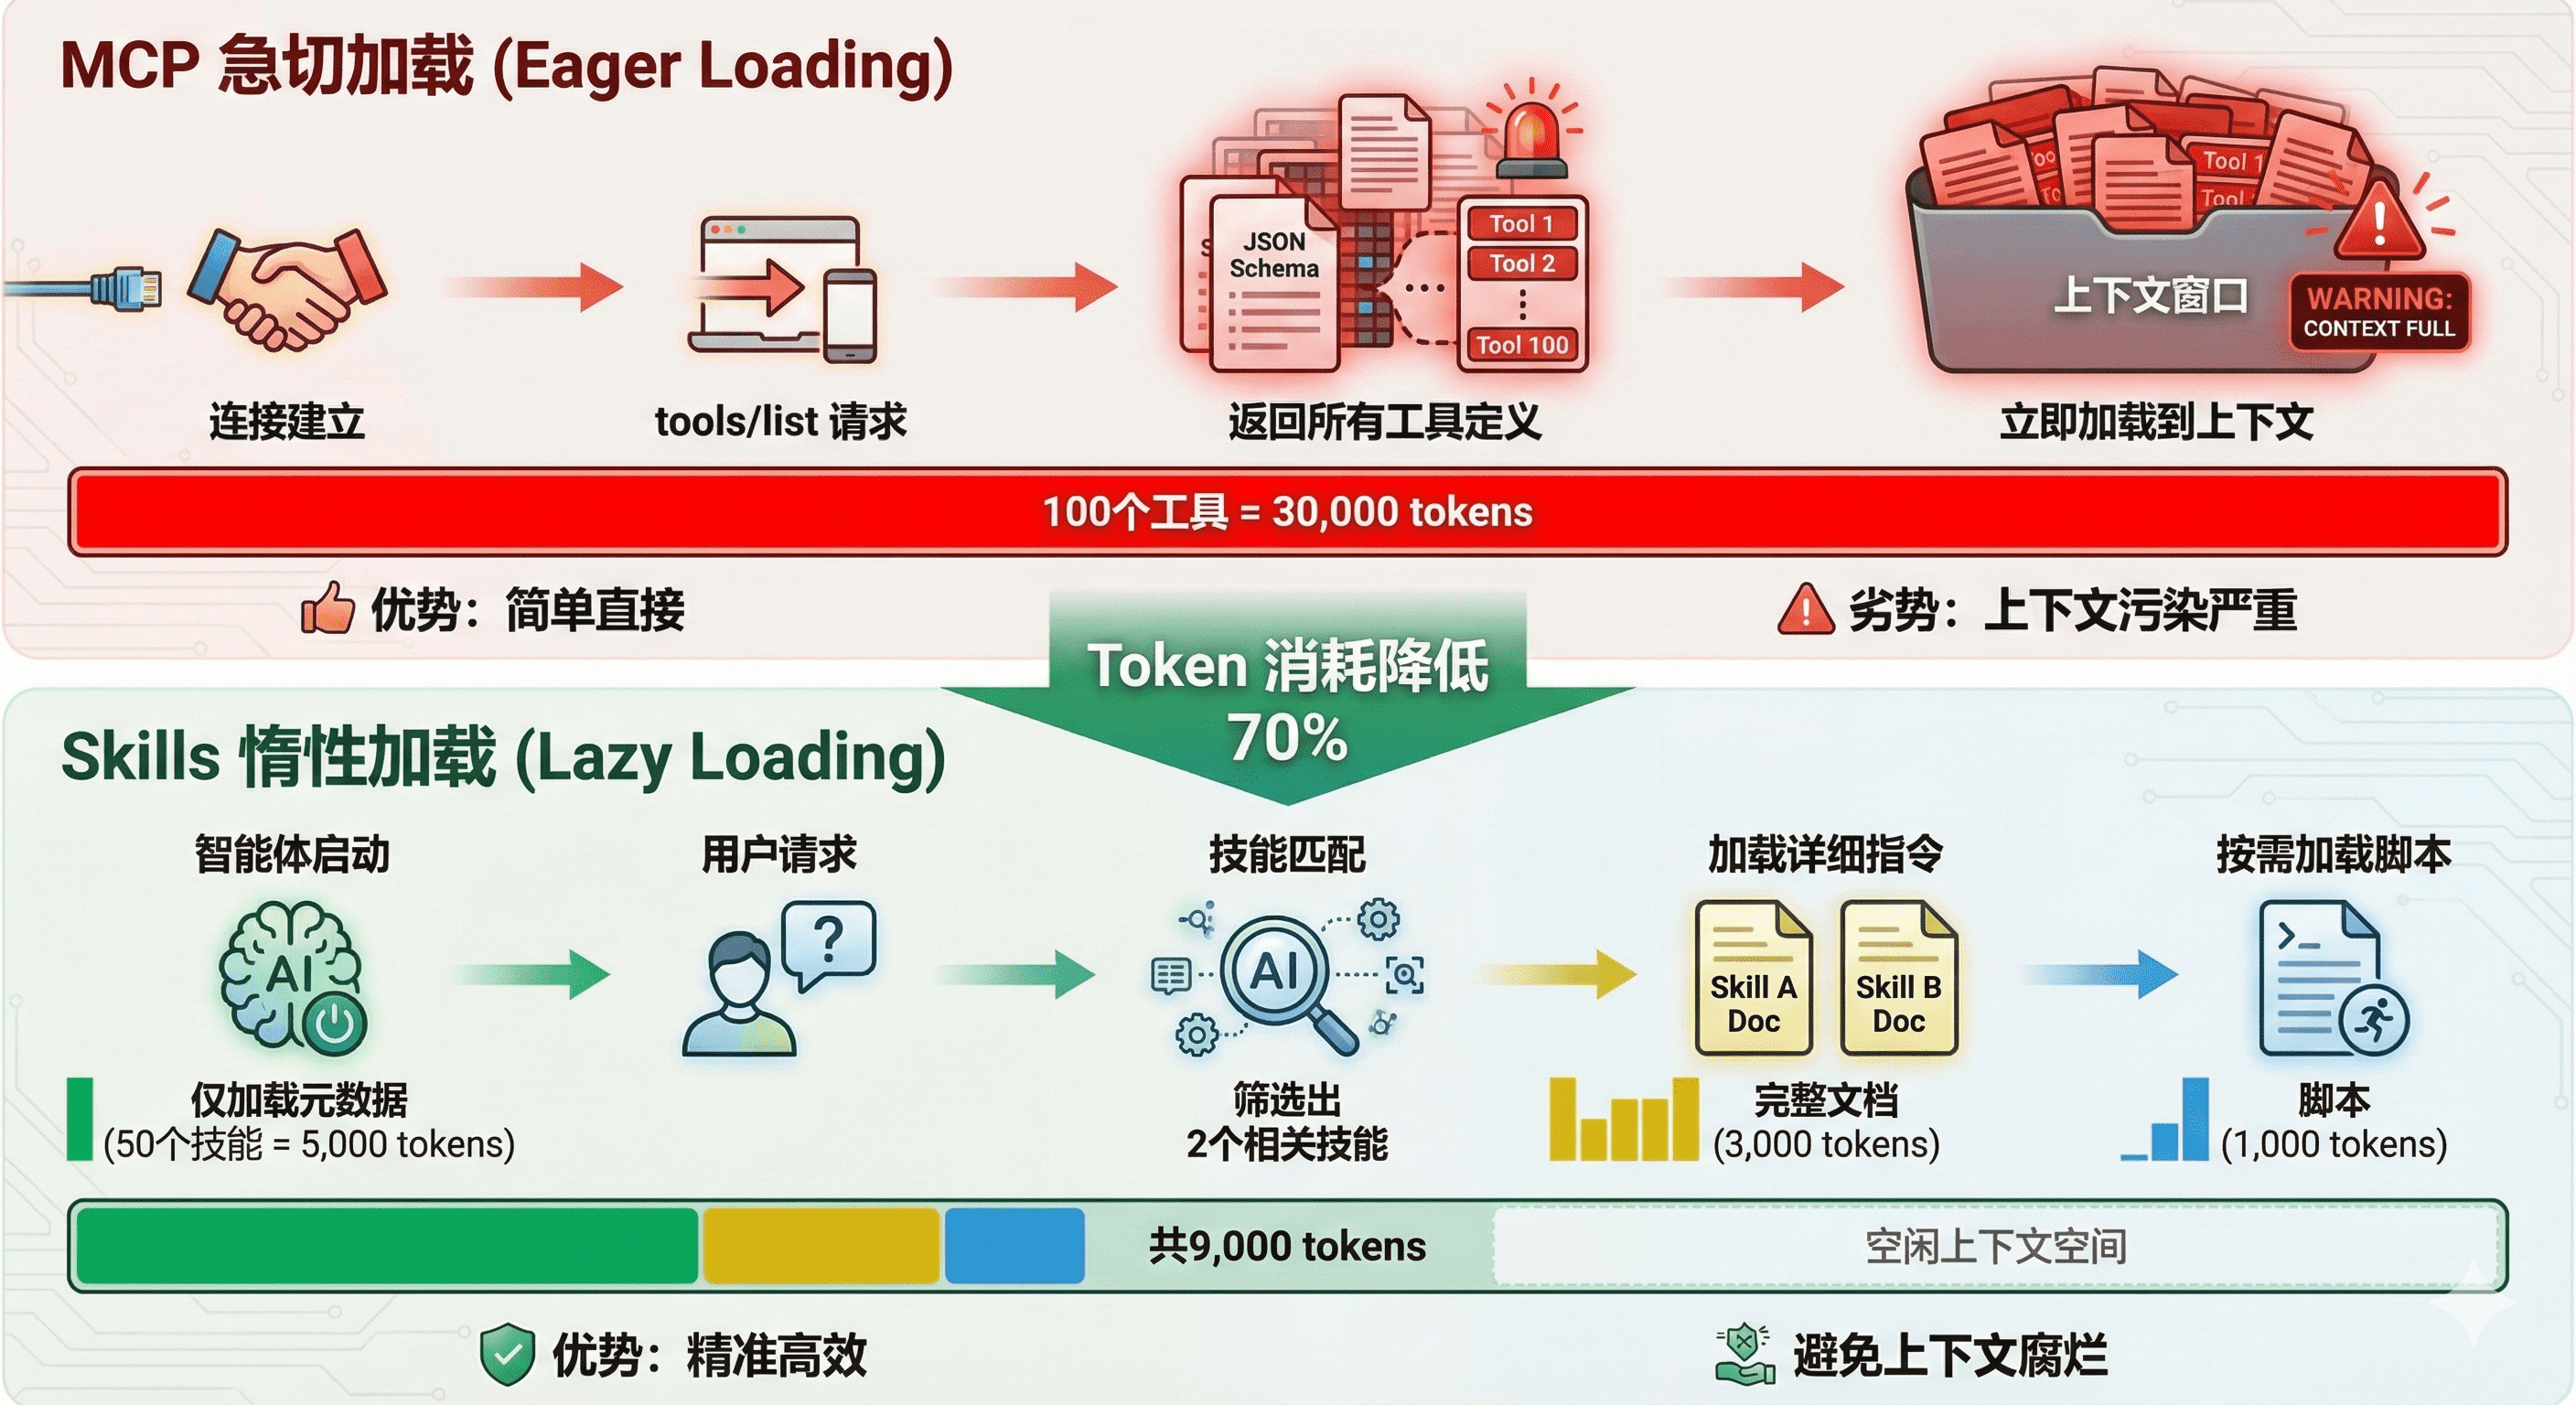
第一个问题是上下文爆炸。为了让智能体能够灵活查询数据库,MCP 服务器通常会暴露数十甚至上百个工具(不同的表、不同的查询方法)。这些工具的完整 JSON Schema 在连接建立时就会被加载到系统提示词中,可能占用数万个 token。据社区开发者反馈,仅加载一个 Playwright MCP 服务器就会占用 200k 上下文窗口的 8%,这在多轮对话中会迅速累积,导致成本飙升和推理能力下降。
第二个问题是能力鸿沟。MCP 解决了"能够连接"的问题,但没有解决"知道如何使用"的问题。拥有数据库连接能力,不等于智能体知道如何编写高效且安全的 SQL;能够访问文件系统,不意味着它理解特定项目的代码结构和开发规范。这就像给一个新手程序员开通了所有系统的访问权限,但没有提供操作手册和最佳实践。
这正是 Agent Skills 要解决的核心问题。2025年初,Anthropic 在推出 MCP 之后,进一步提出了 Agent Skills 的概念,引发了业界的广泛关注。有开发者评论说:"Skills 和 MCP 是两种东西,Skills 是领域知识,告诉模型该如何做,本质上是高级 Prompt;而 MCP 对接外部工具和数据。" 也有人认为:"从 Function Call 到 Tool Call 到 MCP 到 Skills,核心大差不差,就是工程实践和表现形式的优化演进。"
那么,Agent Skills 到底是什么?它与 MCP 有何本质区别?两者是竞争关系还是互补关系?本章将深入探讨这些问题。
什么是 Agent Skills?
核心设计理念
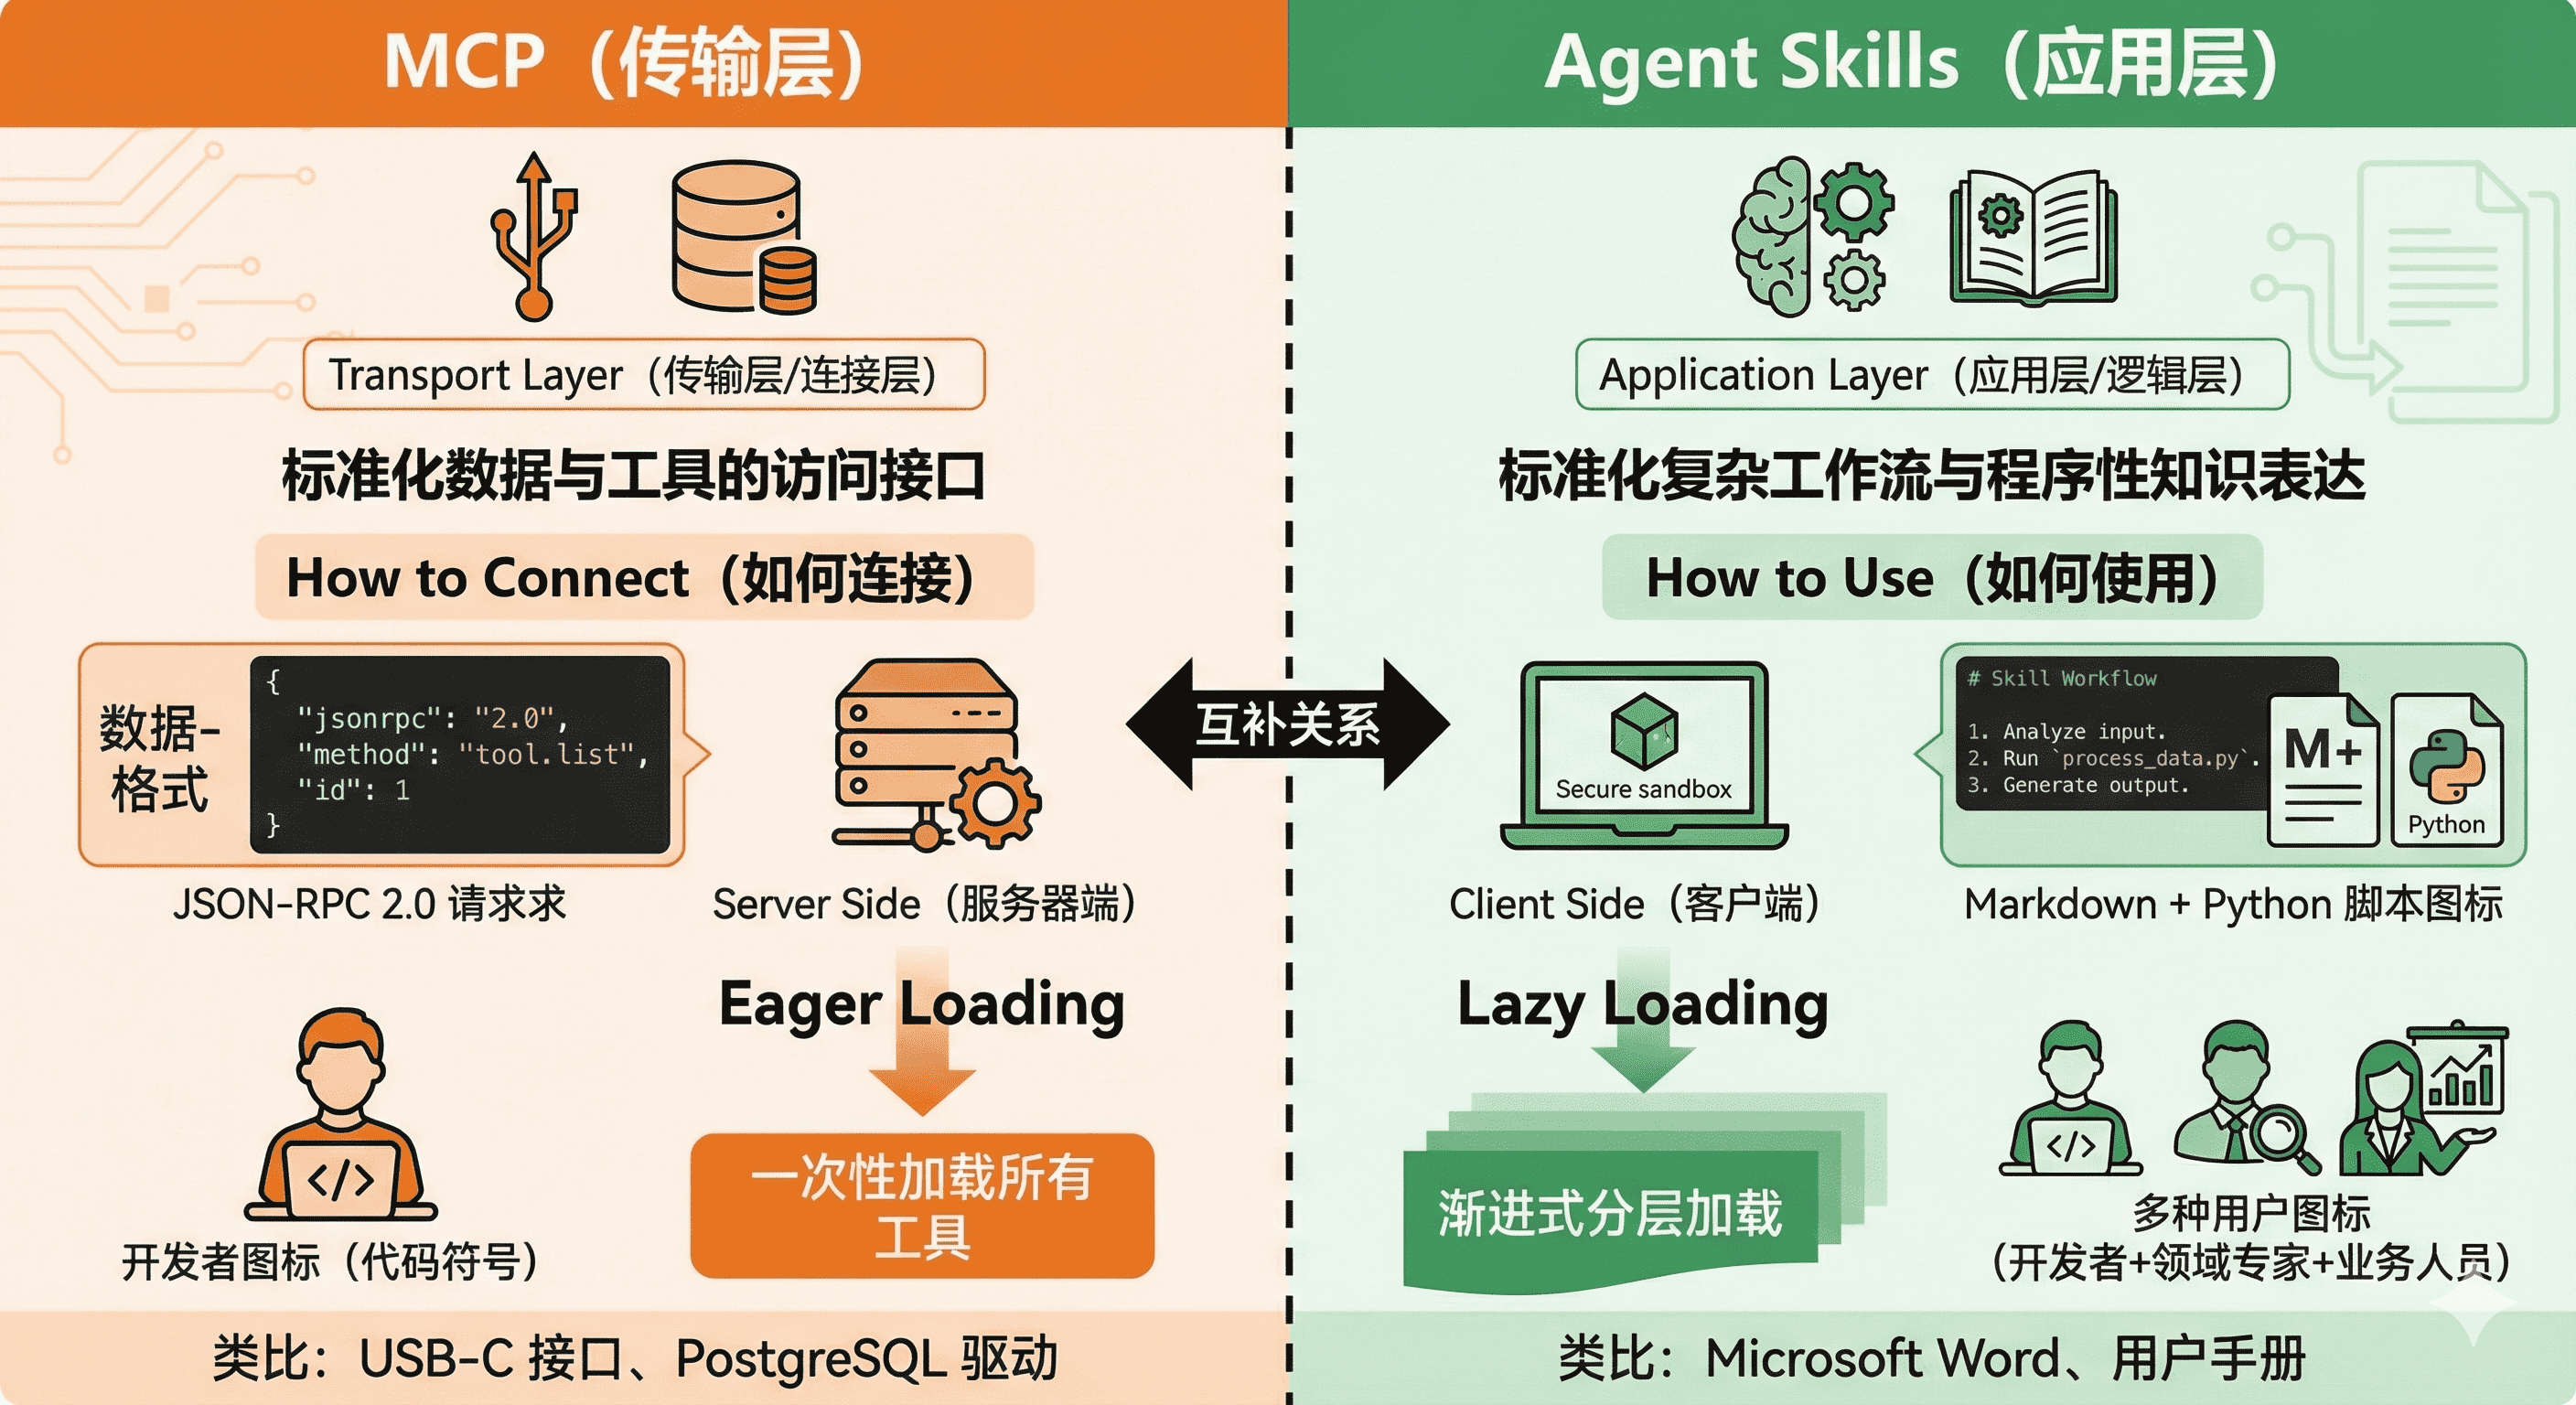
Agent Skills 是一种标准化的程序性知识封装格式。如果说 MCP 为智能体提供了"手"来操作工具,那么 Skills 就提供了"操作手册"或"SOP(标准作业程序)",教导智能体如何正确使用这些工具。
这种设计理念源于一个简单但深刻的洞察:连接性(Connectivity)与能力(Capability)应该分离。MCP 专注于前者,Skills 专注于后者。这种职责分离带来了清晰的架构优势:
- MCP 的职责:提供标准化的访问接口,让智能体能够"够得着"外部世界的数据和工具
- Skills 的职责:提供领域专业知识,告诉智能体在特定场景下"如何组合使用这些工具"
用一个类比来理解:MCP 像是 USB 接口或驱动程序,它定义了设备如何连接;而 Skills 像是软件应用程序,它定义了如何使用这些连接的设备来完成具体任务。你可以拥有一个功能完善的打印机驱动(MCP),但如果没有告诉你如何在 Word 里设置页边距和双面打印(Skill),你仍然无法高效地完成打印任务。
渐进式披露:破解上下文困境
Agent Skills 最核心的创新是渐进式披露(Progressive Disclosure)机制。这种机制将技能信息分为三个层次,智能体按需逐步加载,既确保必要时不遗漏细节,又避免一次性将过多内容塞入上下文窗口。
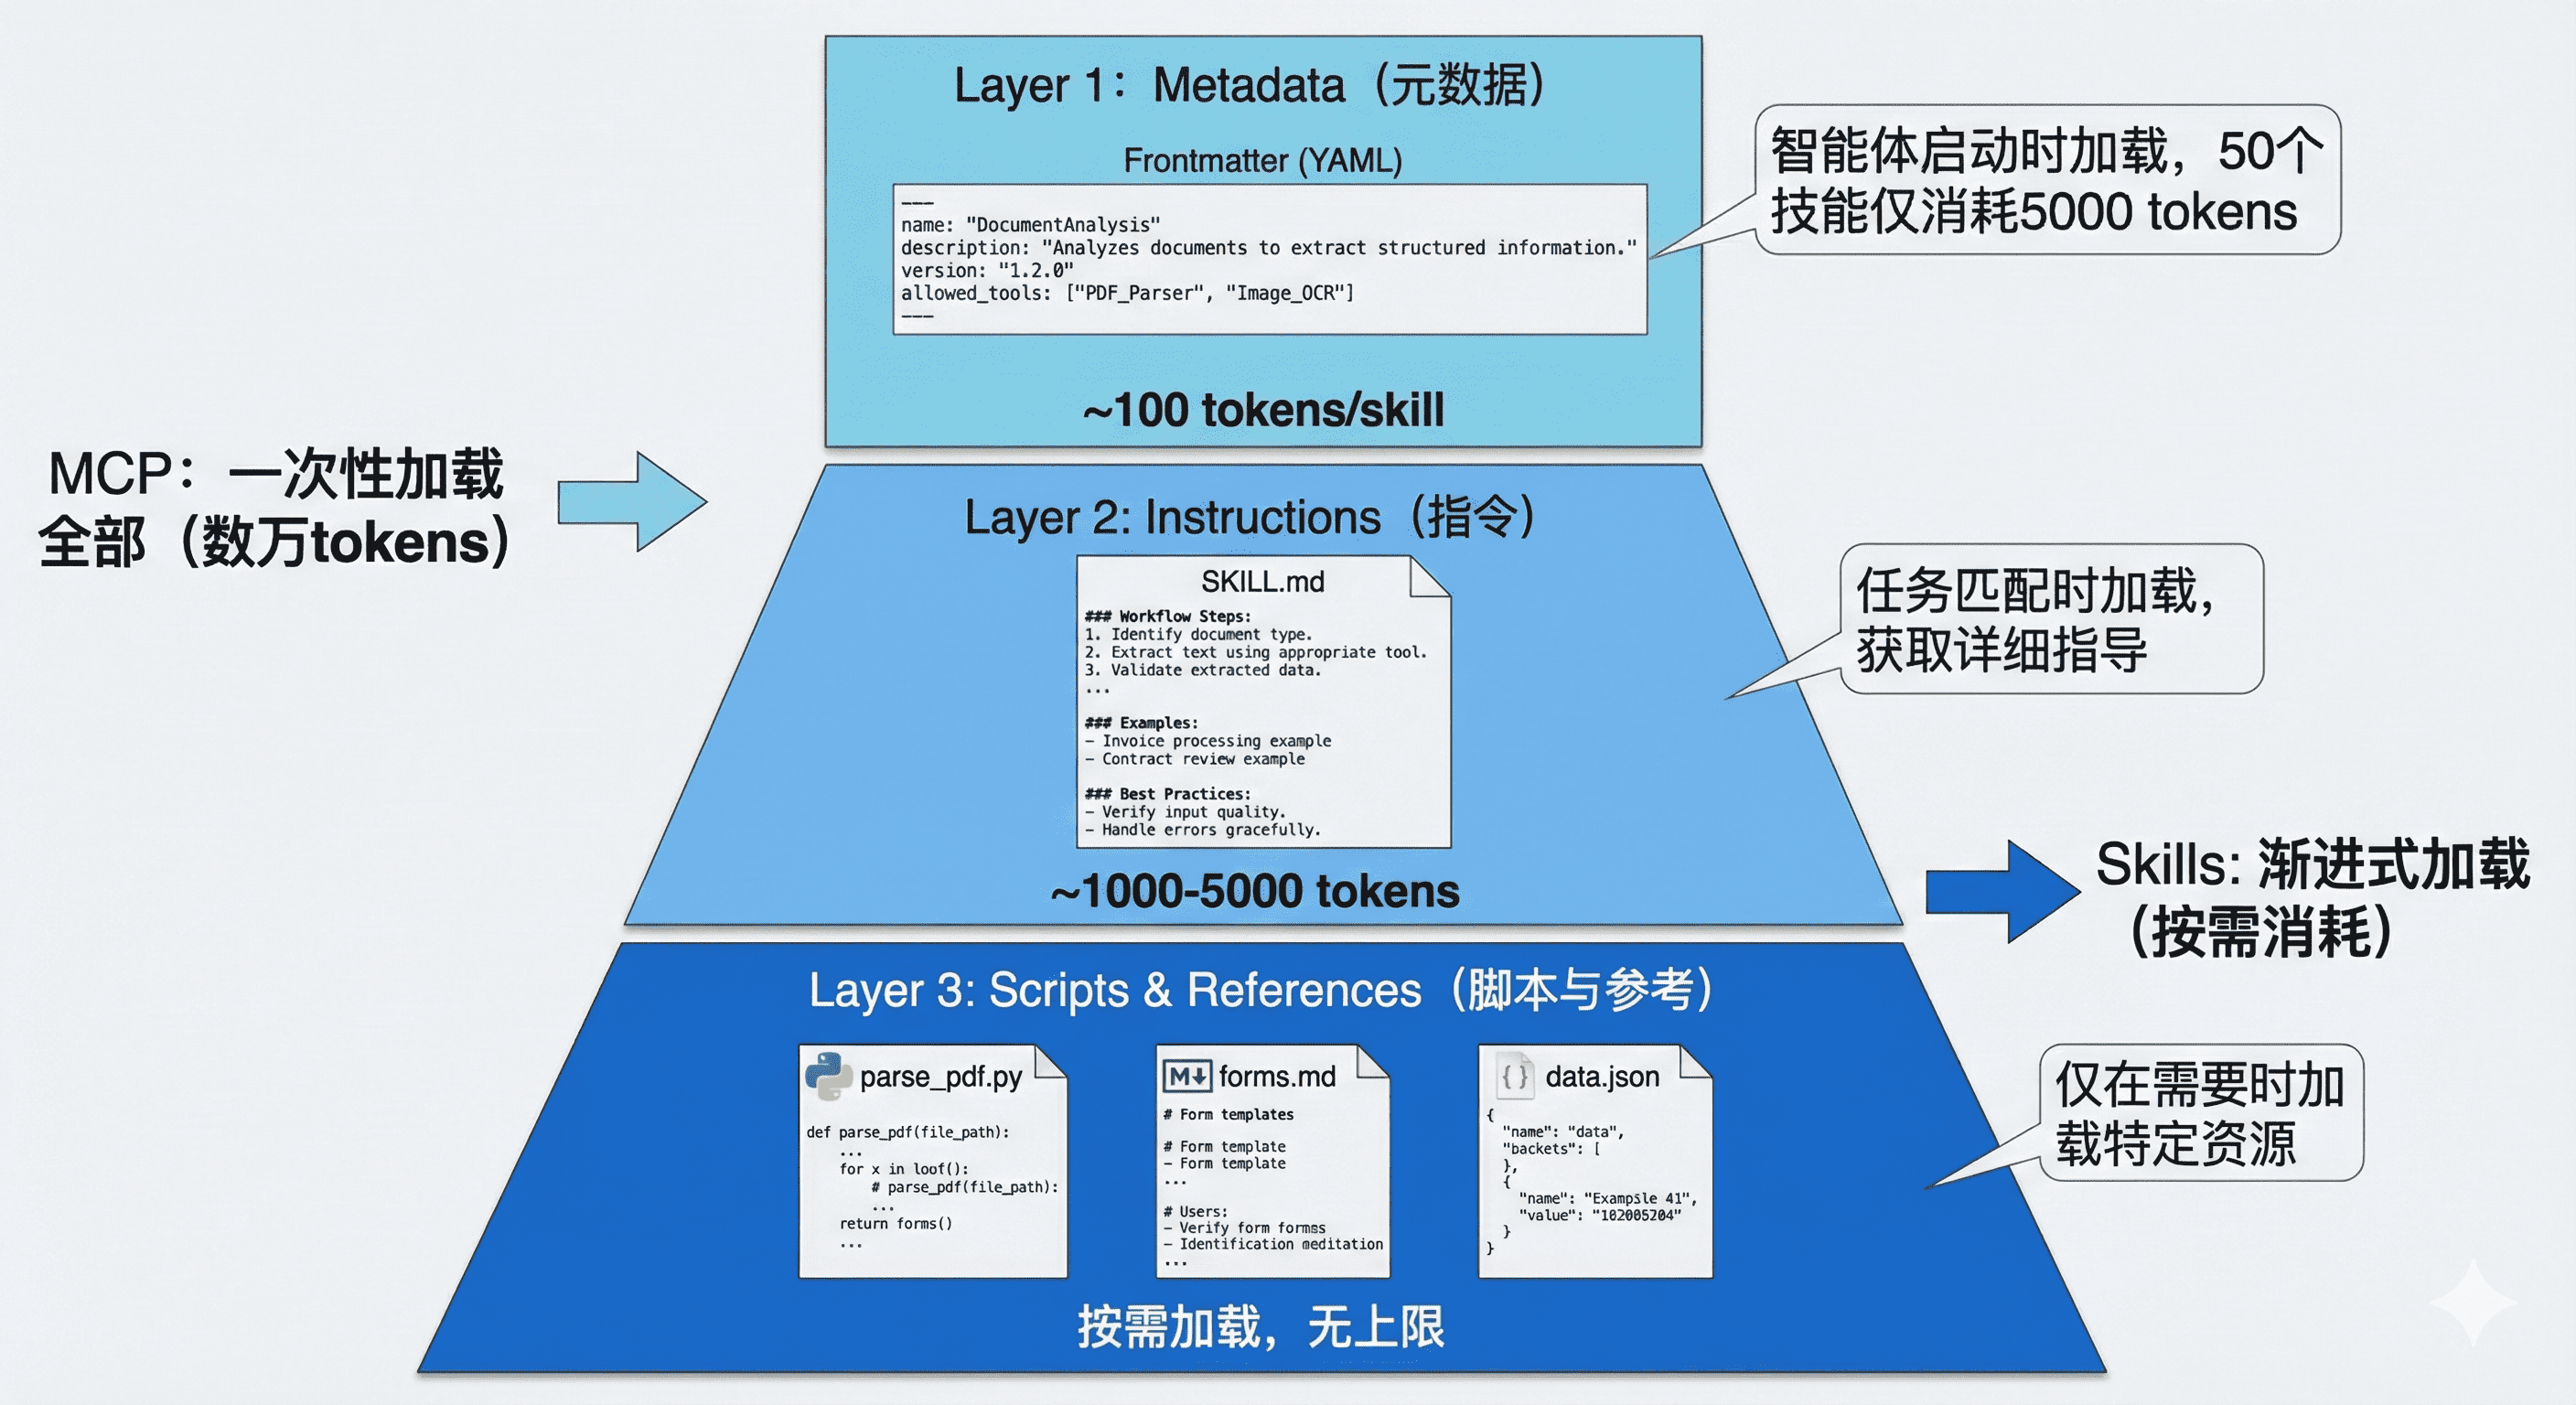
第一层:元数据(Metadata)
在 Skills 的设计中,每个技能都存放在一个独立的文件夹中,核心是一个名为 SKILL.md 的 Markdown 文件。这个文件必须以 YAML 格式的 Frontmatter 开头,定义技能的基本信息。
当智能体启动时,它会扫描所有已安装的技能文件夹,仅读取每个 SKILL.md 的 Frontmatter 部分,将这些元数据加载到系统提示词中。根据实测数据,每个技能的元数据仅消耗约 100 个 token。即使你安装了 50 个技能,初始的上下文消耗也只有约 5,000 个 token。
这与 MCP 的工作方式形成了鲜明对比。在典型的 MCP 实现中,当客户端连接到一个服务器时,通常会通过 tools/list 请求获取所有可用工具的完整 JSON Schema,可能立即消耗数万个 token。
第二层:技能主体(Instructions)
当智能体通过分析用户请求,判断某个技能与当前任务高度相关时,它会进入第二层加载。此时,智能体会读取该技能的完整 SKILL.md 文件内容,将详细的指令、注意事项、示例等加载到上下文中。
此时,智能体获得了完成任务所需的全部上下文:数据库结构、查询模式、注意事项等。这部分内容的 token 消耗取决于指令的复杂度,通常在 1,000 到 5,000 个 token 之间。
第三层:附加资源(Scripts & References)
对于更复杂的技能,SKILL.md 可以引用同一文件夹下的其他文件:脚本、配置文件、参考文档等。智能体仅在需要时才加载这些资源。
例如,一个 PDF 处理技能的文件结构可能是:
skills/pdf-processing/
├── SKILL.md # 主技能文件
├── parse_pdf.py # PDF 解析脚本
├── forms.md # 表单填写指南(仅在填表任务时加载)
└── templates/ # PDF 模板文件
├── invoice.pdf
└── report.pdf
在 SKILL.md 中,可以这样引用附加资源:
- 当需要执行 PDF 解析时,智能体会运行
parse_pdf.py脚本 - 当遇到表单填写任务时,才会加载
forms.md了解详细步骤 - 模板文件只在需要生成特定格式文档时访问
这种设计有两个关键优势:
-
无限的知识容量:通过脚本和外部文件,技能可以"携带"远超上下文限制的知识。例如,一个数据分析技能可以附带一个 1GB 的数据文件和一个查询脚本,智能体通过执行脚本来访问数据,而无需将整个数据集加载到上下文中。
-
确定性执行:复杂的计算、数据转换、格式解析等任务交给代码执行,避免了 LLM 生成过程中的不确定性和幻觉问题。
渐进式披露的效果:从 16k 到 500 Token
社区开发者分享的实践案例充分证明了渐进式披露的威力。在一个真实场景中:
- 传统 MCP 方式:直接连接一个包含大量工具定义的 MCP 服务器,初始加载消耗 16,000 个 token
- Skills 包装后:创建一个简单的 Skill 作为"网关",仅在 Frontmatter 中描述功能,初始消耗仅 500 个 token
当智能体确定需要使用该技能时,才会加载详细指令并按需调用底层的 MCP 工具。这种架构不仅大幅降低了初始成本,还使得对话过程中的上下文管理更加精准和高效。
Agent Skills vs MCP:本质区别与协作关系
现在,我们可以系统地比较这两种技术的本质区别了。
从工程视角理解差异
让我们通过一个具体的例子来理解这种差异。假设你要构建一个智能体来帮助团队进行代码审查:
MCP 的职责:
# MCP 提供对 GitHub 的标准化访问
github_mcp = MCPTool(server_command=["npx", "-y", "@modelcontextprotocol/server-github"])
# MCP 暴露的工具(简化示例):
# - list_pull_requests(repo, state)
# - get_pull_request_details(pr_number)
# - list_pr_comments(pr_number)
# - create_pr_comment(pr_number, body)
# - get_file_content(repo, path, ref)
# - list_pr_files(pr_number)
MCP 让智能体"能够"访问 GitHub,能够调用这些 API。但它不知道"应该"做什么。
Skills 的职责:
---
name: code-review-workflow
description: 执行标准的代码审查流程,包括检查代码风格、安全问题、测试覆盖率等
---
# 代码审查工作流
## 审查清单
当执行代码审查时,按以下步骤进行:
1. **获取 PR 信息**:调用 `get_pull_request_details` 了解变更背景
2. **分析变更文件**:调用 `list_pr_files` 获取文件列表
3. **逐文件审查**:
- 对于 `.py` 文件:检查是否符合 PEP 8,是否有明显的性能问题
- 对于 `.js/.ts` 文件:检查是否有未处理的 Promise,是否使用了废弃的 API
- 对于测试文件:验证是否覆盖了新增的代码路径
4. **安全检查**:
- 是否硬编码了敏感信息(密钥、密码)
- 是否有 SQL 注入或 XSS 风险
5. **提供反馈**:
- 严重问题:使用 `create_pr_comment` 直接评论
- 建议改进:在总结中提出
## 公司特定规范
- 所有数据库查询必须使用参数化查询
- API 端点必须有权限验证装饰器
- 新功能必须附带单元测试(覆盖率 > 80%)
## 示例评论模板
**严重问题**:
⚠️ 安全风险:第 45 行直接拼接 SQL 字符串,存在注入风险。
建议改用参数化查询:`cursor.execute("SELECT * FROM users WHERE id = ?", (user_id,))`
Skills 告诉智能体"应该"做什么、如何组织审查流程、需要关注哪些公司特定的规范。它是领域知识和最佳实践的容器。
上下文管理策略的本质差异
互补而非竞争:Skills + MCP 的混合架构
理解了两者的差异后,我们会发现:Skills 和 MCP 不是竞争关系,而是互补关系。最佳实践是将两者结合,形成分层架构:
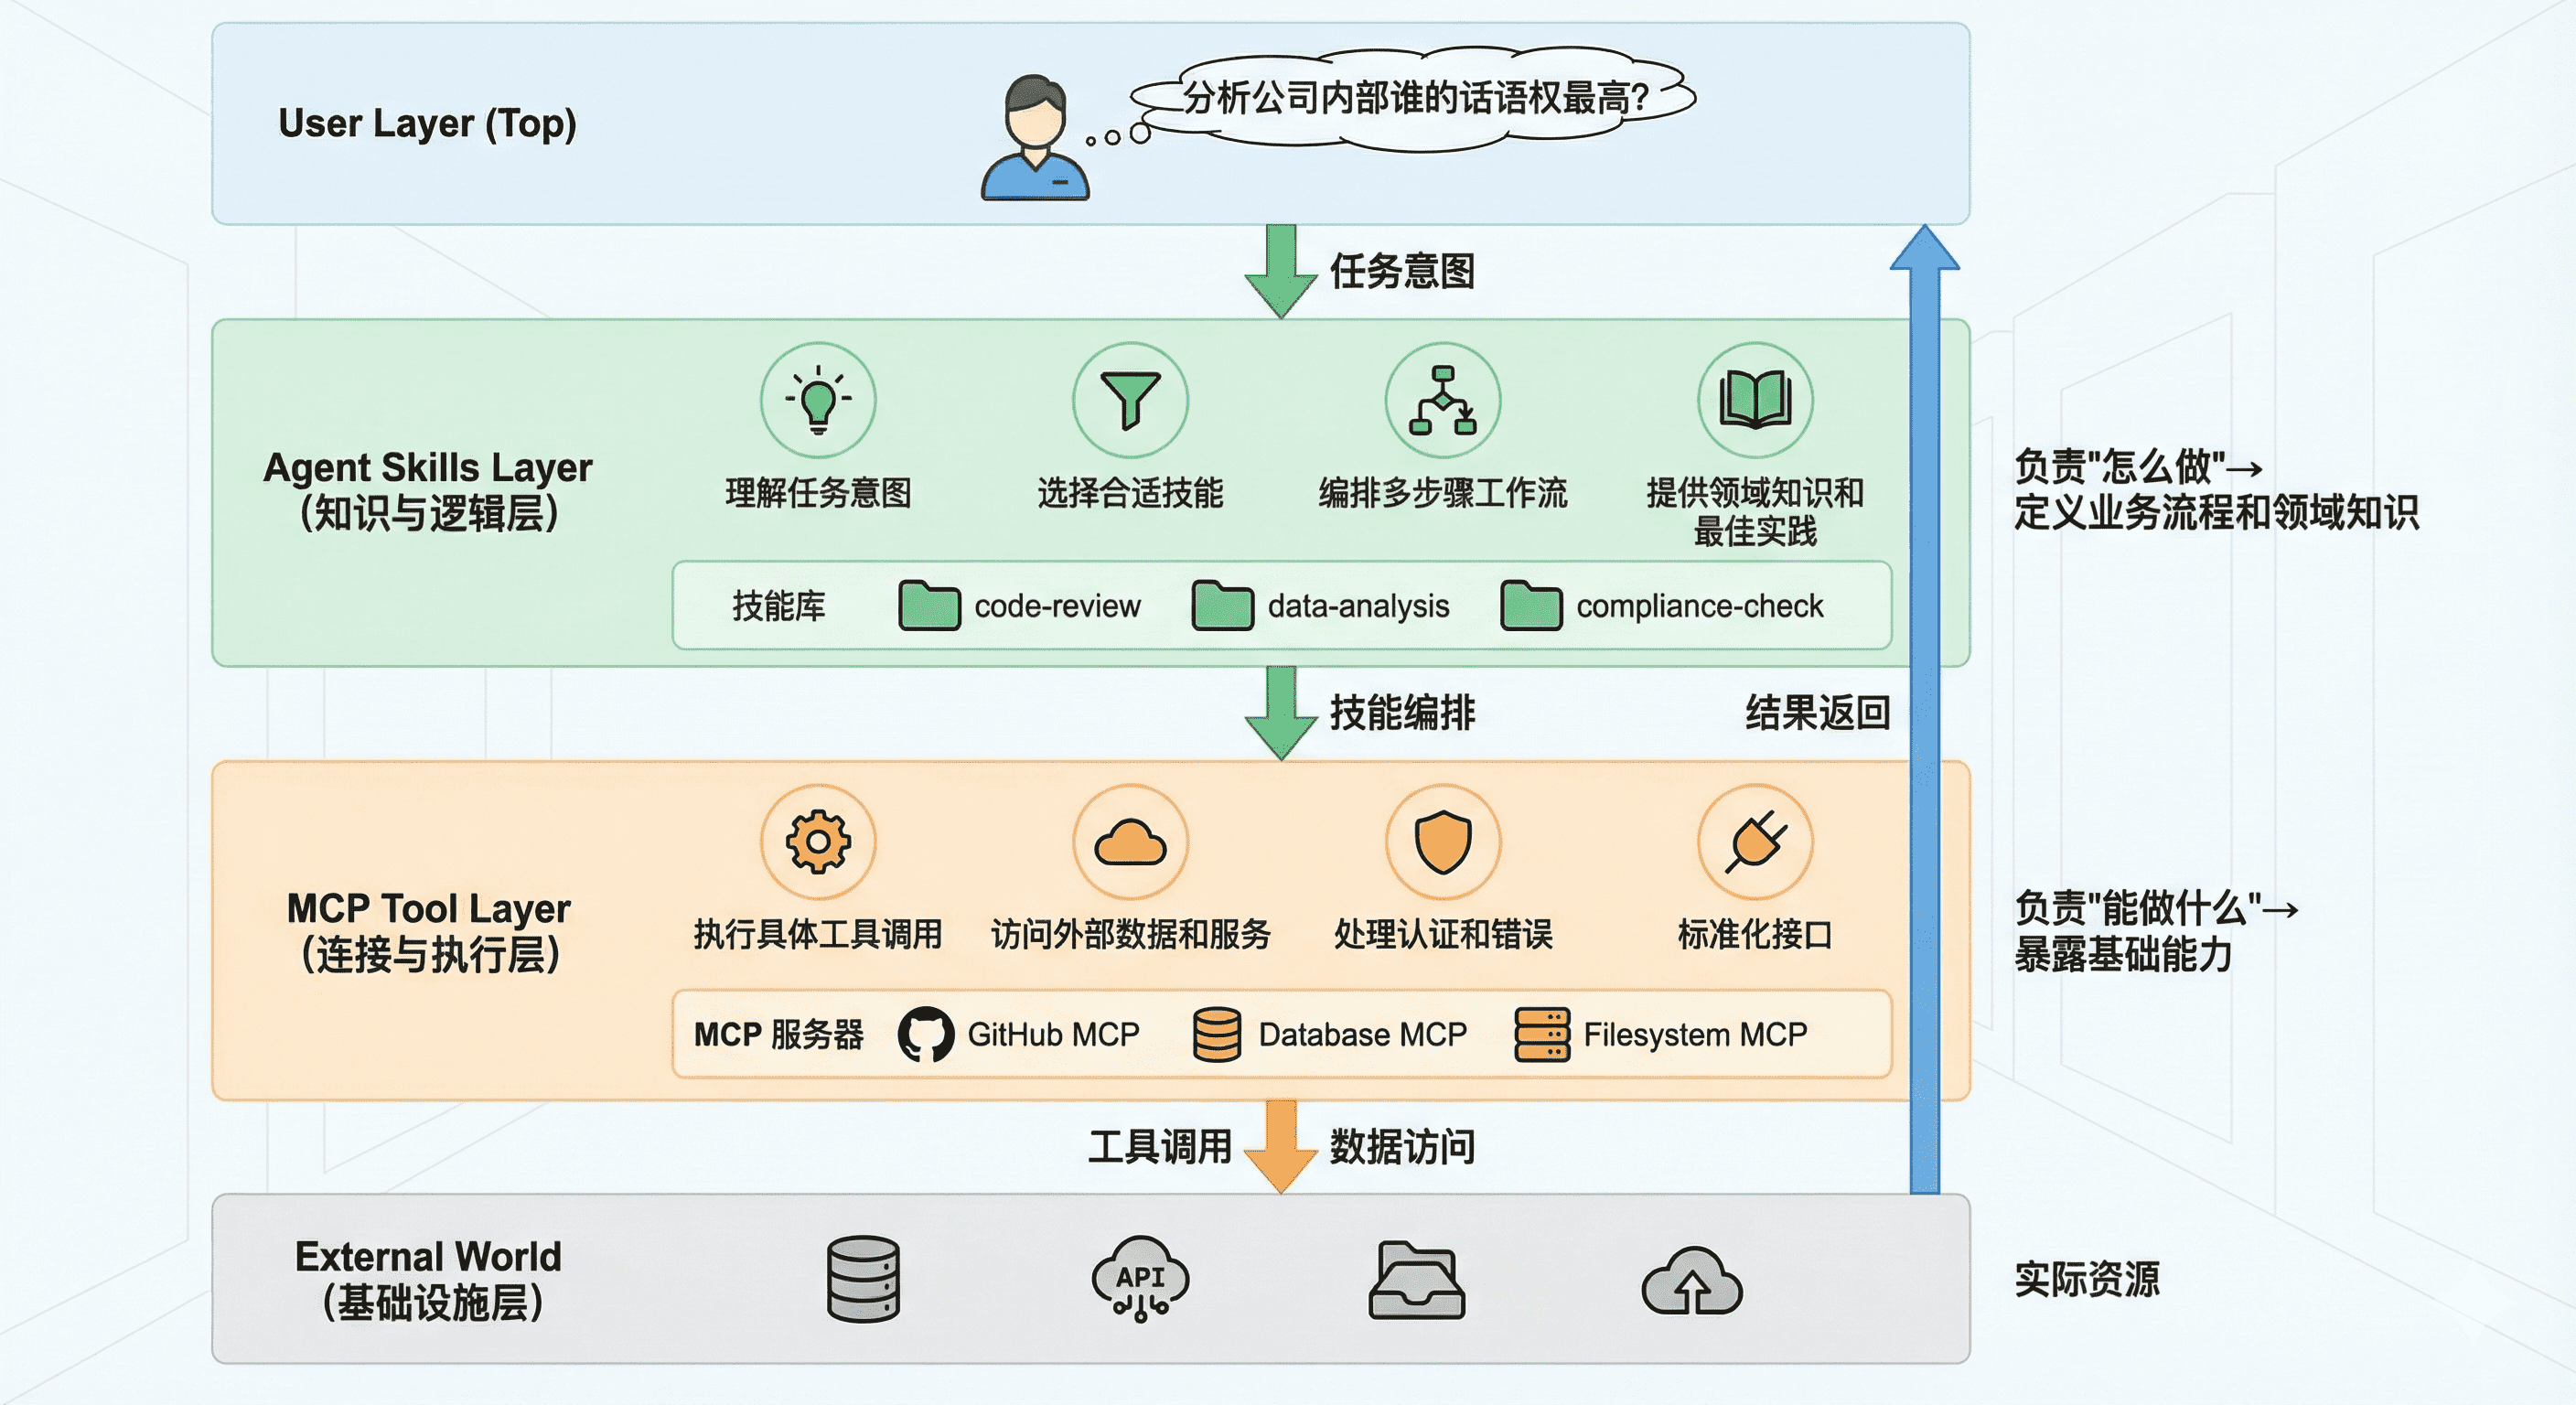 典型工作流:
- 用户问:"分析公司内部谁的话语权最高"
- Skills 层识别这是一个数据分析任务,加载
mysql-employees-analysis技能 - Skills 层根据技能指令,将任务分解为子步骤:查询管理关系、薪资对比、任职时长等
- MCP 层执行具体的 SQL 查询,返回结果
- Skills 层根据技能中的领域知识,解读数据并生成综合分析
- 返回结构化的答案给用户
这种架构的优势是:
- 关注点分离:MCP 专注于"能力",Skills 专注于"智慧"
- 成本优化:渐进式加载大幅降低 token 消耗
- 可维护性:业务逻辑(Skills)与基础设施(MCP)解耦
- 复用性:同一个 MCP 服务器可以被多个 Skills 使用
技术实现:如何创建和使用 Skills
SKILL.md 规范详解
让我们深入了解 SKILL.md 文件的标准结构:
---
# === 必需字段 ===
name: skill-name
# 技能的唯一标识符,使用 kebab-case 命名
description: >
简洁但精确的描述,说明:
1. 这个技能做什么
2. 什么时候应该使用它
3. 它的核心价值是什么
# 注意:description 是智能体选择技能的唯一依据,必须写清楚!
# === 可选字段 ===
version: 1.0.0
# 语义化版本号
allowed_tools: [tool1, tool2]
# 此技能可以调用的工具列表(白名单)
required_context: [context_item1]
# 此技能需要的上下文信息
license: MIT
# 许可协议
author: Your Name <email@example.com>
# 作者信息
tags: [database, analysis, sql]
# 便于分类和搜索的标签
---
# 技能标题
## 概述
(对技能的详细介绍,包括使用场景、技术背景等)
## 前置条件
(使用此技能需要的环境配置、依赖项等)
## 工作流程
(详细的步骤说明,告诉智能体如何执行任务)
## 最佳实践
(经验总结、注意事项、常见陷阱等)
## 示例
(具体的使用案例,帮助智能体理解)
## 故障排查
(常见问题和解决方案)
编写高质量 Skills 的原则
根据 Anthropic 官方文档和社区最佳实践,编写有效的 Skills 需要遵循以下原则:
1. 精准的 Description
description 是智能体决策的关键。它应该:
- 精确定义适用范围:避免模糊的描述如"帮助处理数据"
- 包含触发关键词:让智能体能够匹配用户意图
- 说明独特价值:与其他技能区分开来
❌ 不好的 description:
description: 处理数据库查询
✅ 好的 description:
description: >
将中文业务问题转换为 SQL 查询并分析 MySQL employees 示例数据库。
适用于员工信息查询、薪资统计、部门分析、职位变动历史等场景。
当用户询问关于员工、薪资、部门的数据时使用此技能。
2. 模块化与单一职责
一个 Skill 应该专注于一个明确的领域或任务类型。如果一个 Skill 试图做太多事情,会导致:
- Description 过于宽泛,匹配精度下降
- 指令内容过长,浪费上下文
- 难以维护和更新
建议:与其创建一个"通用数据分析"技能,不如创建多个专门的技能:
mysql-employees-analysis:专门分析 employees 数据库sales-data-analysis:专门分析销售数据user-behavior-analysis:专门分析用户行为数据
3. 确定性优先原则
对于复杂的、需要精确执行的任务,优先使用脚本而不是依赖 LLM 生成。例如,在数据导出场景中,与其让 LLM 生成 Excel 二进制内容(容易出错),不如编写一个专门的脚本来处理这个任务,SKILL.md 中只需要指导智能体何时调用这个脚本即可。
4. 渐进式披露策略
合理利用三层结构,将信息按重要性和使用频率分层:
- SKILL.md 主体:放置核心工作流、常用模式
- 附加文档(如
advanced.md):放置高级用法、边缘情况 - 数据文件:放置大型参考数据,通过脚本按需查询
实践案例:MySQL 员工分析 Skill 详解
让我们通过 Anthropic 社区的一个真实案例,了解 Agent Skills 的具体应用。这个技能用于分析 MySQL 官方的 employees 示例数据库。
技能文件结构
skills/mysql-employees-analysis/
├── SKILL.md # 主技能文件(包含元数据和详细指令)
└── db_schema.sql # 数据库结构参考(可选,按需加载)
SKILL.md 核心内容示例
这个技能的 Frontmatter(元数据层):
---
name: mysql-employees-analysis
description: >
将中文业务问题转换为 SQL 查询并分析 MySQL employees 示例数据库。
适用于员工信息查询(如"工号12345的员工信息")、
薪资统计(如"平均薪资最高的部门")、
部门分析(如"各部门人数分布")、
职位变动历史(如"某员工的晋升路径")等场景。
version: 1.0.0
allowed_tools: [execute_sql]
tags: [database, mysql, sql, employees, analysis]
---
# MySQL 员工数据库分析技能
## 概述
这个技能专门用于分析 MySQL 官方提供的 `employees` 示例数据库。
该数据库包含约 300,000 名虚拟员工的记录,涵盖 1985-2000 年的数据。
**核心能力**:
- 理解中文自然语言的业务问题
- 转换为高效的 SQL 查询
- 执行查询并解读结果
- 提供业务洞察和数据解读
## 数据库结构
### 核心表结构
| 表名 | 说明 | 关键字段 |
| -------------- | ------------ | ------------------------------------------------------------ |
| `employees` | 员工基本信息 | emp_no, birth_date, first_name, last_name, gender, hire_date |
| `salaries` | 薪资历史 | emp_no, salary, from_date, to_date |
| `titles` | 职位历史 | emp_no, title, from_date, to_date |
| `dept_emp` | 员工部门关系 | emp_no, dept_no, from_date, to_date |
| `dept_manager` | 部门经理 | emp_no, dept_no, from_date, to_date |
| `departments` | 部门信息 | dept_no, dept_name |
### 关键约定
⚠️ **重要**:`to_date = '9999-01-01'` 表示"当前有效"的记录。
查询"当前"状态时(如现任员工、当前薪资),必须加此过滤条件。
完整的表结构参见:`db_schema.sql`
## 工作流程
### 第一步:理解需求
仔细分析用户的中文描述,识别:
- **查询目标**:要查什么数据?(员工、薪资、部门...)
- **筛选条件**:有什么限制?(特定部门、时间范围、薪资区间...)
- **聚合维度**:需要统计吗?(平均值、总数、排名...)
- **时间范围**:是历史数据还是当前状态?
### 第二步:构建 SQL
根据需求选择合适的查询模式(见下方"常见查询模式")。
**编写原则**:
1. 使用明确的表别名(如 `e` for employees)
2. JOIN 时优先使用主键/外键
3. 注意日期过滤(特别是 `to_date`)
4. 合理使用索引字段
5. 大结果集要加 LIMIT
### 第三步:执行查询
调用 `execute_sql` 工具执行构建好的 SQL。
```python
# 示例调用(智能体会自动转换为工具调用)
result = execute_sql(query="SELECT ...")
### 第四步:解读结果
将查询结果转化为自然语言回答:
- 用表格呈现结构化数据
- 突出关键数据点
- 提供业务洞察(如趋势、异常)
- 如果结果为空,说明可能的原因
## 常见查询模式
### 模式 1:基础信息查询
-- 查询特定员工的基本信息
SELECT emp_no, CONCAT(first_name, ' ', last_name) AS full_name,
gender, birth_date, hire_date
FROM employees
WHERE emp_no = <员工号>;
### 模式 2:当前状态查询
-- 查询当前薪资最高的员工(TOP 10)
SELECT e.emp_no,
CONCAT(e.first_name, ' ', e.last_name) AS name,
s.salary
FROM employees e
JOIN salaries s ON e.emp_no = s.emp_no
WHERE s.to_date = '9999-01-01' -- 当前薪资
ORDER BY s.salary DESC
LIMIT 10;
### 模式 3:历史趋势分析
-- 查询某员工的薪资变化历史
SELECT emp_no, salary, from_date, to_date,
salary - LAG(salary) OVER (ORDER BY from_date) AS increase
FROM salaries
WHERE emp_no = <员工号>
ORDER BY from_date;
### 模式 4:跨表关联查询
-- 查询各部门的平均薪资(当前)
SELECT d.dept_name,
COUNT(DISTINCT de.emp_no) AS emp_count,
ROUND(AVG(s.salary), 2) AS avg_salary
FROM departments d
JOIN dept_emp de ON d.dept_no = de.dept_no
JOIN salaries s ON de.emp_no = s.emp_no
WHERE de.to_date = '9999-01-01' -- 当前在职
AND s.to_date = '9999-01-01' -- 当前薪资
GROUP BY d.dept_name
ORDER BY avg_salary DESC;
### 模式 5:复杂业务分析
-- 分析"话语权":综合管理层级、薪资、任职时长
WITH manager_hierarchy AS (
-- 统计每个经理管理的下属数
SELECT dm.emp_no, COUNT(de.emp_no) AS subordinate_count
FROM dept_manager dm
JOIN dept_emp de ON dm.dept_no = de.dept_no
WHERE dm.to_date = '9999-01-01'
AND de.to_date = '9999-01-01'
AND de.emp_no != dm.emp_no
GROUP BY dm.emp_no
),
current_salary AS (
-- 当前薪资
SELECT emp_no, salary
FROM salaries
WHERE to_date = '9999-01-01'
),
tenure AS (
-- 任职时长(年)
SELECT emp_no,
TIMESTAMPDIFF(YEAR, hire_date, CURDATE()) AS years_employed
FROM employees
)
SELECT e.emp_no,
CONCAT(e.first_name, ' ', e.last_name) AS name,
COALESCE(mh.subordinate_count, 0) AS team_size,
cs.salary,
t.years_employed,
-- 简单的话语权评分(可根据业务调整权重)
(COALESCE(mh.subordinate_count, 0) * 10 +
cs.salary / 1000 +
t.years_employed * 5) AS influence_score
FROM employees e
JOIN current_salary cs ON e.emp_no = cs.emp_no
JOIN tenure t ON e.emp_no = t.emp_no
LEFT JOIN manager_hierarchy mh ON e.emp_no = mh.emp_no
WHERE cs.salary > 60000 -- 过滤低薪员工
ORDER BY influence_score DESC
LIMIT 20;
## 注意事项
### ⚠️ 时间字段的正确处理
- <strong>当前状态</strong>:必须使用 `to_date = '9999-01-01'` 过滤
- <strong>历史查询</strong>:注意 `from_date` 和 `to_date` 的范围
- <strong>时间计算</strong>:使用 `TIMESTAMPDIFF`、`DATEDIFF` 等函数
### ⚠️ 性能优化
- <strong>大表 JOIN</strong>:优先使用索引字段(emp_no, dept_no)
- <strong>聚合查询</strong>:合理使用 GROUP BY 和 HAVING
- <strong>结果限制</strong>:对于展示类查询,添加 LIMIT 限制
- <strong>子查询优化</strong>:复杂查询使用 WITH (CTE) 提高可读性和性能
### ⚠️ 数据质量
- <strong>NULL 值处理</strong>:使用 COALESCE 或 IFNULL 处理空值
- <strong>重复记录</strong>:注意员工可能多次调岗,查询时考虑去重
- <strong>数据范围</strong>:数据库只包含 1985-2000 年的数据,查询时注意时间边界
## 故障排查
<strong>问题 1:查询结果为空</strong>
- 检查是否正确使用了 `to_date = '9999-01-01'`
- 验证员工号或部门号是否存在
- 检查日期范围是否合理
<strong>问题 2:查询速度慢</strong>
- 检查是否缺少索引字段的 WHERE 条件
- 考虑将复杂查询拆分为多步
- 使用 EXPLAIN 分析查询计划
<strong>问题 3:统计数据不准确</strong>
- 注意区分"历史"和"当前"状态
- 检查 JOIN 条件是否遗漏
- 验证聚合函数的使用是否正确
这个 SKILL.md 文件展示了一个完整技能的结构:
- 清晰的元数据(智能体用于发现和匹配)
- 完整的数据库结构说明
- 详细的工作流程指导
- 丰富的查询模式示例(可直接复用的 SQL 模板)
- 实用的注意事项和故障排查
技能的使用效果
当用户向支持 Agent Skills 的智能体(如 Claude Desktop、Claude Code)提问时:
用户问题:
"分析公司内部谁的话语权最高?需要综合考虑管理层级、薪资水平和任职时长。"
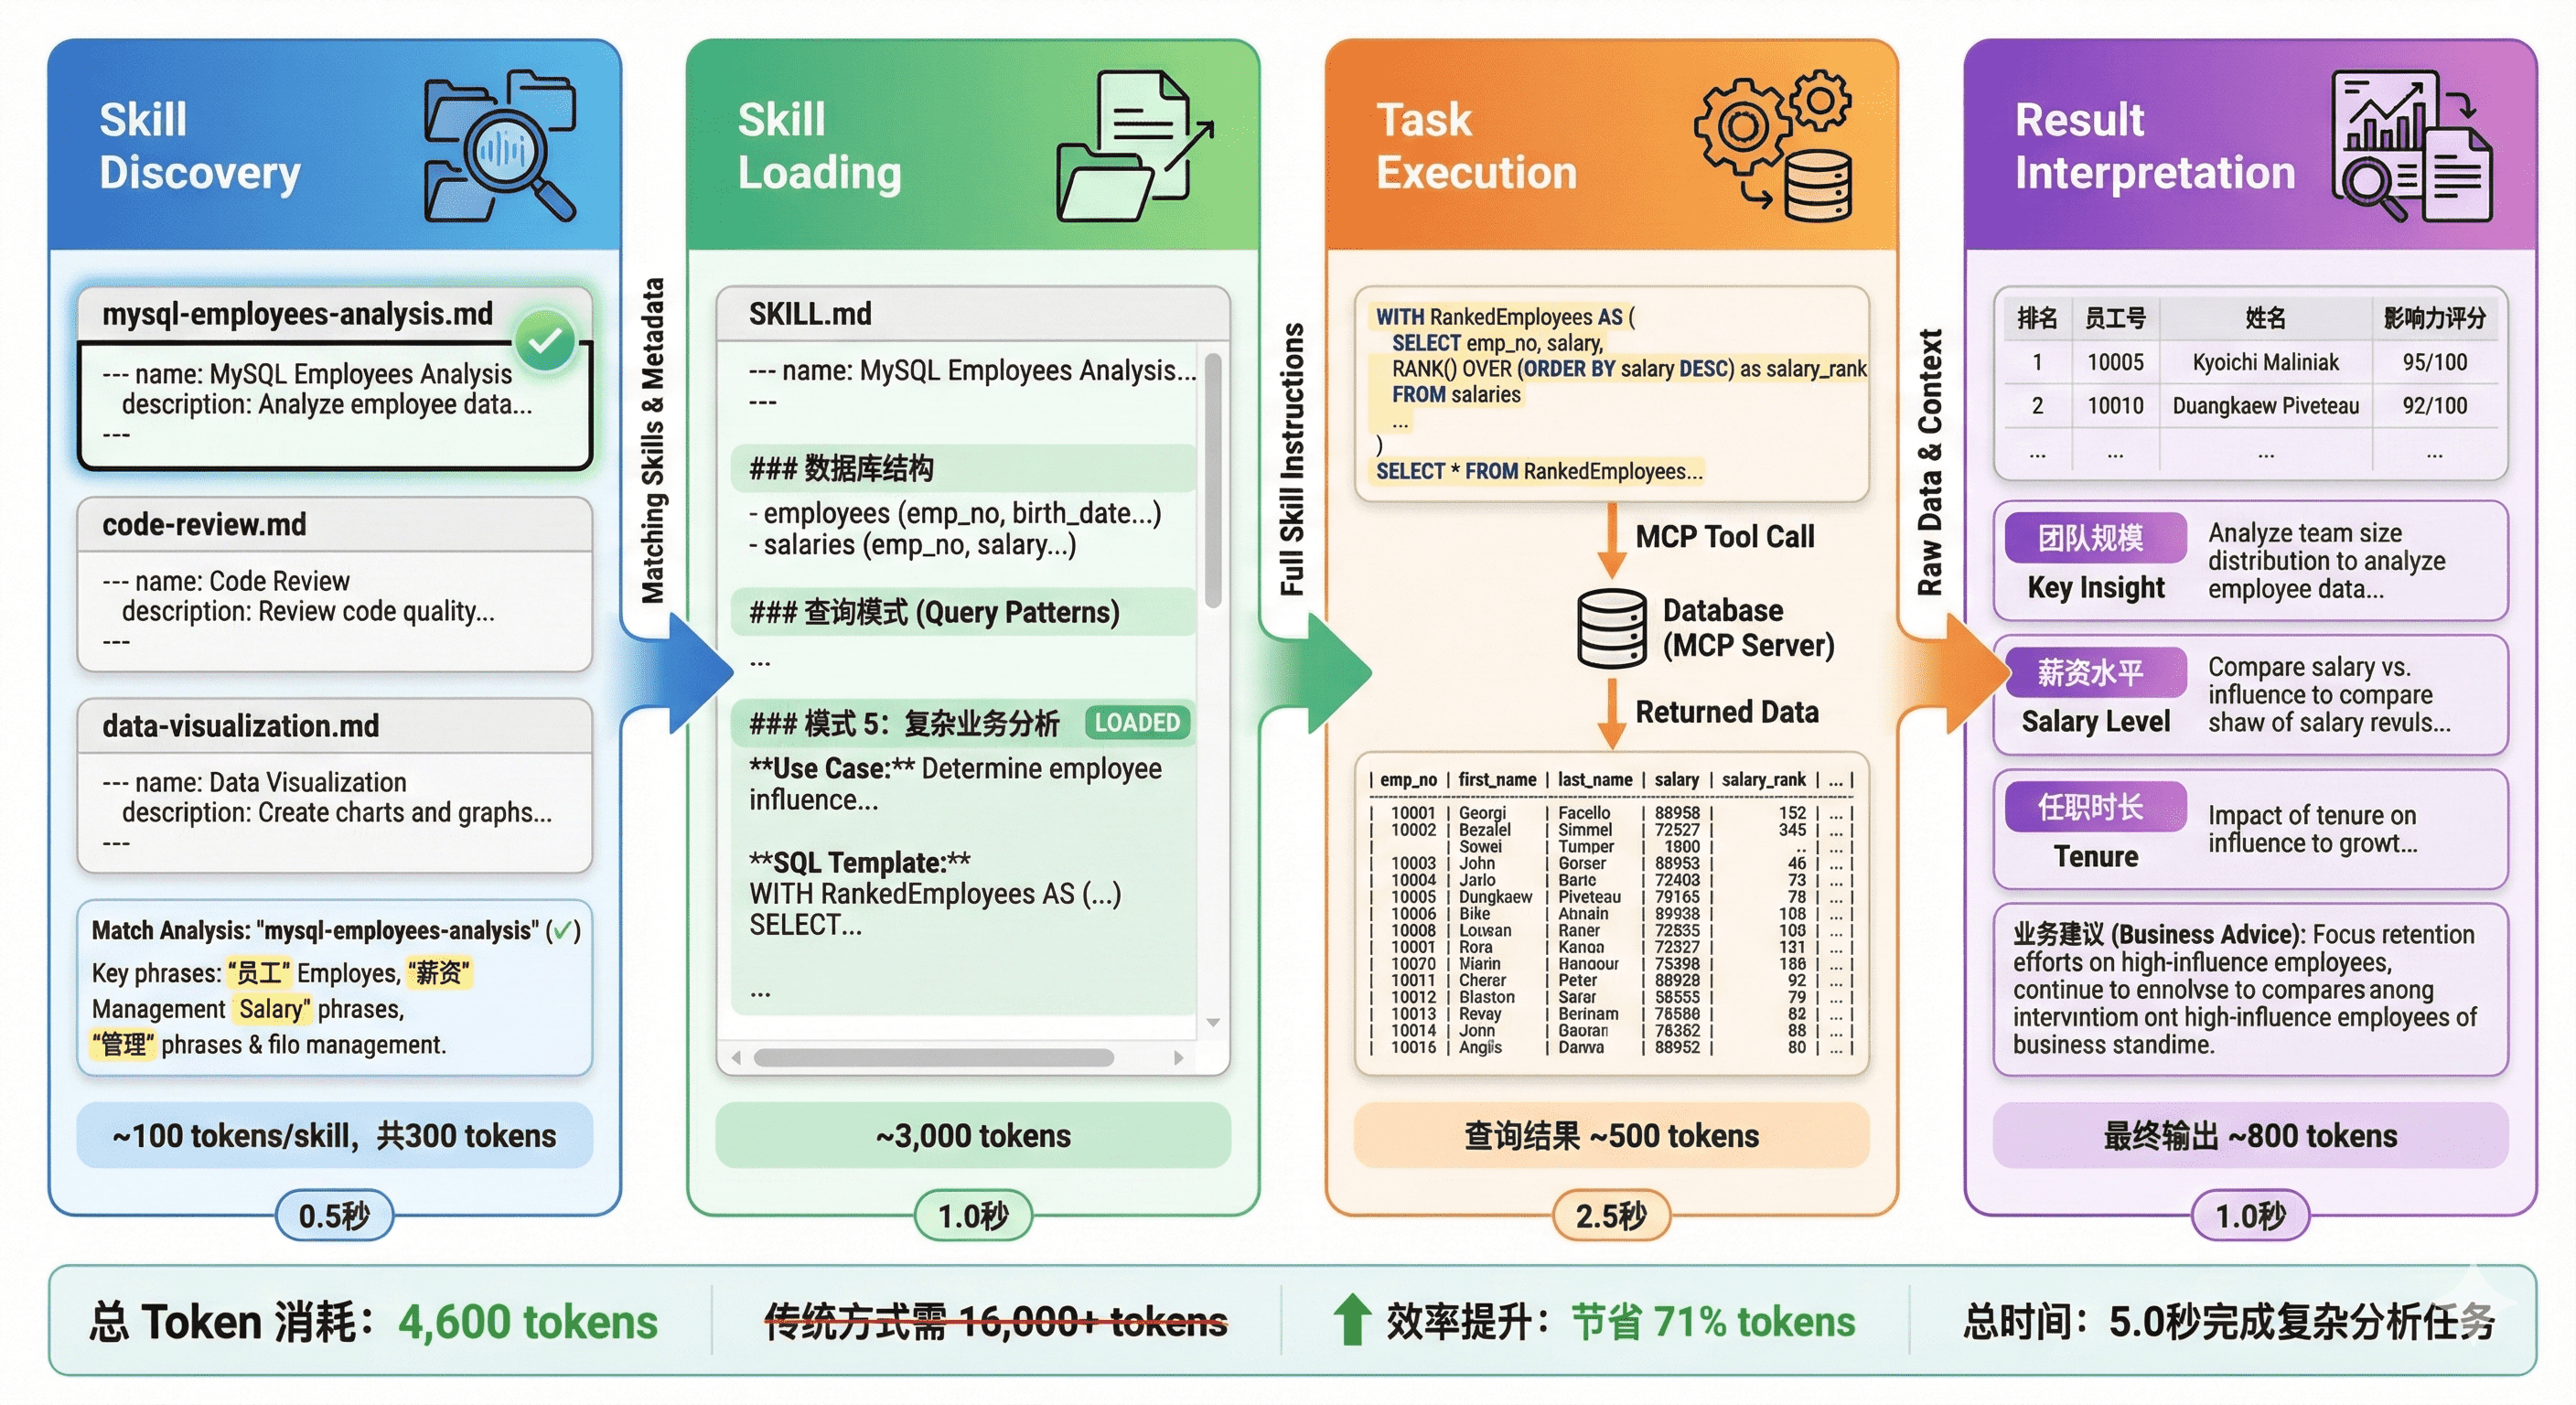
输出示例:
| 排名 | 员工号 | 姓名 | 团队规模 | 薪资 | 任职年限 | 影响力评分 |
|---|---|---|---|---|---|---|
| 1 | 110022 | Margareta Markovitch | 45 | 152,710 | 18 | 692.71 |
| 2 | 110039 | Vishwani Minakawa | 38 | 138,273 | 16 | 598.27 |
| 3 | 110085 | Ebru Alpin | 32 | 124,054 | 15 | 519.05 |
关键洞察:
- 话语权最高的员工通常管理大团队(30+人)、薪资前1%(>12万)、任职超15年
- 部门经理的影响力远超普通员工,管理规模是关键因素
- 长期任职的高薪员工即使不担任管理职务,也具有较强的话语权
整个过程中,技能提供了:
- 领域知识:如何衡量"话语权"(管理规模+薪资+任职时长)
- 技术指导:如何编写高效的 SQL(使用 CTE、窗口函数、多表 JOIN)
- 业务理解:如何解读数据并生成洞察
Skills 的分享与复用
Agent Skills 的另一个重要特性是社区化。Anthropic 建立了官方的 Skills 仓库:
官方技能库:https://github.com/anthropics/skills
截至 2025 年,已有数百个社区贡献的技能,覆盖:
- 开发工具:前端设计、API 测试、代码审查、Git 工作流
- 数据分析:SQL 查询、数据可视化、统计分析
- 文档处理:PDF 解析、Markdown 生成、技术文档撰写
- 业务流程:项目管理、客户支持、合规审查
使用社区技能非常简单:
# 克隆官方技能库
git clone https://github.com/anthropics/skills.git
# 复制需要的技能到你的项目
cp -r skills/frontend-design ./my-project/skills/
# 智能体会自动发现并加载
你也可以分享自己的技能:
# 发布到 GitHub
cd my-custom-skill
git init
git add SKILL.md
git commit -m "Add custom SQL analysis skill"
git remote add origin https://github.com/yourname/my-skill.git
git push -u origin main
# 其他开发者可以直接使用
# git clone https://github.com/yourname/my-skill.git
行业动态与生态演进
标准化进程与厂商支持
Agent Skills 虽然由 Anthropic 提出,但其设计理念正在影响整个行业。
Anthropic Claude:
- Claude Desktop 和 Claude Code 原生支持 Skills
- 提供官方 SDK 和开发工具
- 维护官方技能库
OpenAI 的响应: 虽然 OpenAI 尚未官方采用 "Skills" 这个术语,但在 2025 年 3 月的更新中,ChatGPT 引入了类似的概念:
- Custom Instructions 增强:支持更复杂的多步骤指令
- Memory 与 Context Profiles:允许用户保存和复用特定领域的知识
- GPTs 的"知识库"功能:可以附加文档和脚本,按需加载
这些功能本质上是 Skills 理念的不同实现形式。
Google Vertex AI: Google 在 Gemini 模型中引入了 "Grounding with Functions",允许开发者定义"函数包"(Function Packages),每个包包含:
- 函数定义(类似 MCP 的 tools)
- 使用指南(类似 Skills 的 instructions)
- 示例(examples)
这种设计与 Skills + MCP 的混合架构高度相似。
分层架构的必然性
综合各方观点,我们认为:Skills 和 MCP 代表了智能体架构中两个必然分离的层级。随着智能体系统的复杂度增加,这种分层是不可避免的:
应用层(Application Layer)
↓ Agent Skills
↓ 领域知识、工作流、最佳实践
传输层(Transport Layer)
↓ MCP
↓ 标准化接口、工具调用、资源访问
基础设施层(Infrastructure Layer)
↓ 数据库、API、文件系统、外部服务
这与传统软件架构的演进路径完全一致(从单体到分层到微服务),只是在 AI 领域重新演绎了一遍。
标准化的趋势
随着行业对智能体技术的重视,我们预见以下趋势:
1. 协议融合
未来可能出现统一的智能体能力描述协议,融合 MCP 的连接性和 Skills 的知识表达:
# 未来的统一协议示例(假想)
apiVersion: agent.io/v1
kind: Capability
metadata:
name: enterprise-data-analysis
spec:
transport:
protocol: mcp
server: database-mcp-server
tools: [query, schema]
knowledge:
type: skill
workflow: data-analysis-workflow.md
examples: examples/
2. 市场化与生态系统
类似于 NPM、PyPI,未来可能出现智能体能力的包管理系统:
# 假想的未来命令
agent-cli install @anthropic/frontend-design-skill
agent-cli install @google/data-analysis-suite
agent-cli install @openai/code-review-assistant
开发者可以发布、分享、售卖自己的 Skills 和 MCP 服务器,形成繁荣的生态系统。
3. 自动化能力发现
智能体可能发展出自动发现和学习新能力的机制:
# 未来的智能体可能具备自主学习能力
agent = SelfEvolvingAgent()
# 智能体在执行任务时发现缺少某种能力
response = agent.run("生成 3D 建模文件")
# 智能体自动搜索并安装相关 Skill
# [内部日志] 检测到未知任务类型:3D建模
# [内部日志] 搜索技能库...发现 "blender-3d-modeling" skill
# [内部日志] 请求用户授权安装...已授权
# [内部日志] 技能安装完成,重新执行任务
挑战与风险
与此同时,我们也需要警惕潜在的风险:
安全性挑战:
- Skills 包含可执行脚本,存在代码注入风险
- MCP 服务器可能暴露敏感数据接口
- 第三方技能的可信度难以验证
上下文污染:
- 随着 Skills 数量增加,即使是元数据也可能占用大量上下文
- 需要更智能的技能索引和检索机制
碎片化风险:
- 虽然 MCP 正在标准化,但 Skills 格式尚未统一
- 不同厂商可能推出不兼容的 Skills 规范
总结
Agent Skills 和 MCP 代表了智能体技术栈中两个关键的抽象层:
- MCP(Model Context Protocol):解决"连接性"问题,是智能体与外部世界交互的标准化接口,相当于"神经系统"或"双手"
- Agent Skills:解决"能力"问题,是领域知识和工作流的封装,相当于"大脑皮层"或"操作手册"
两者不是竞争关系,而是互补关系:
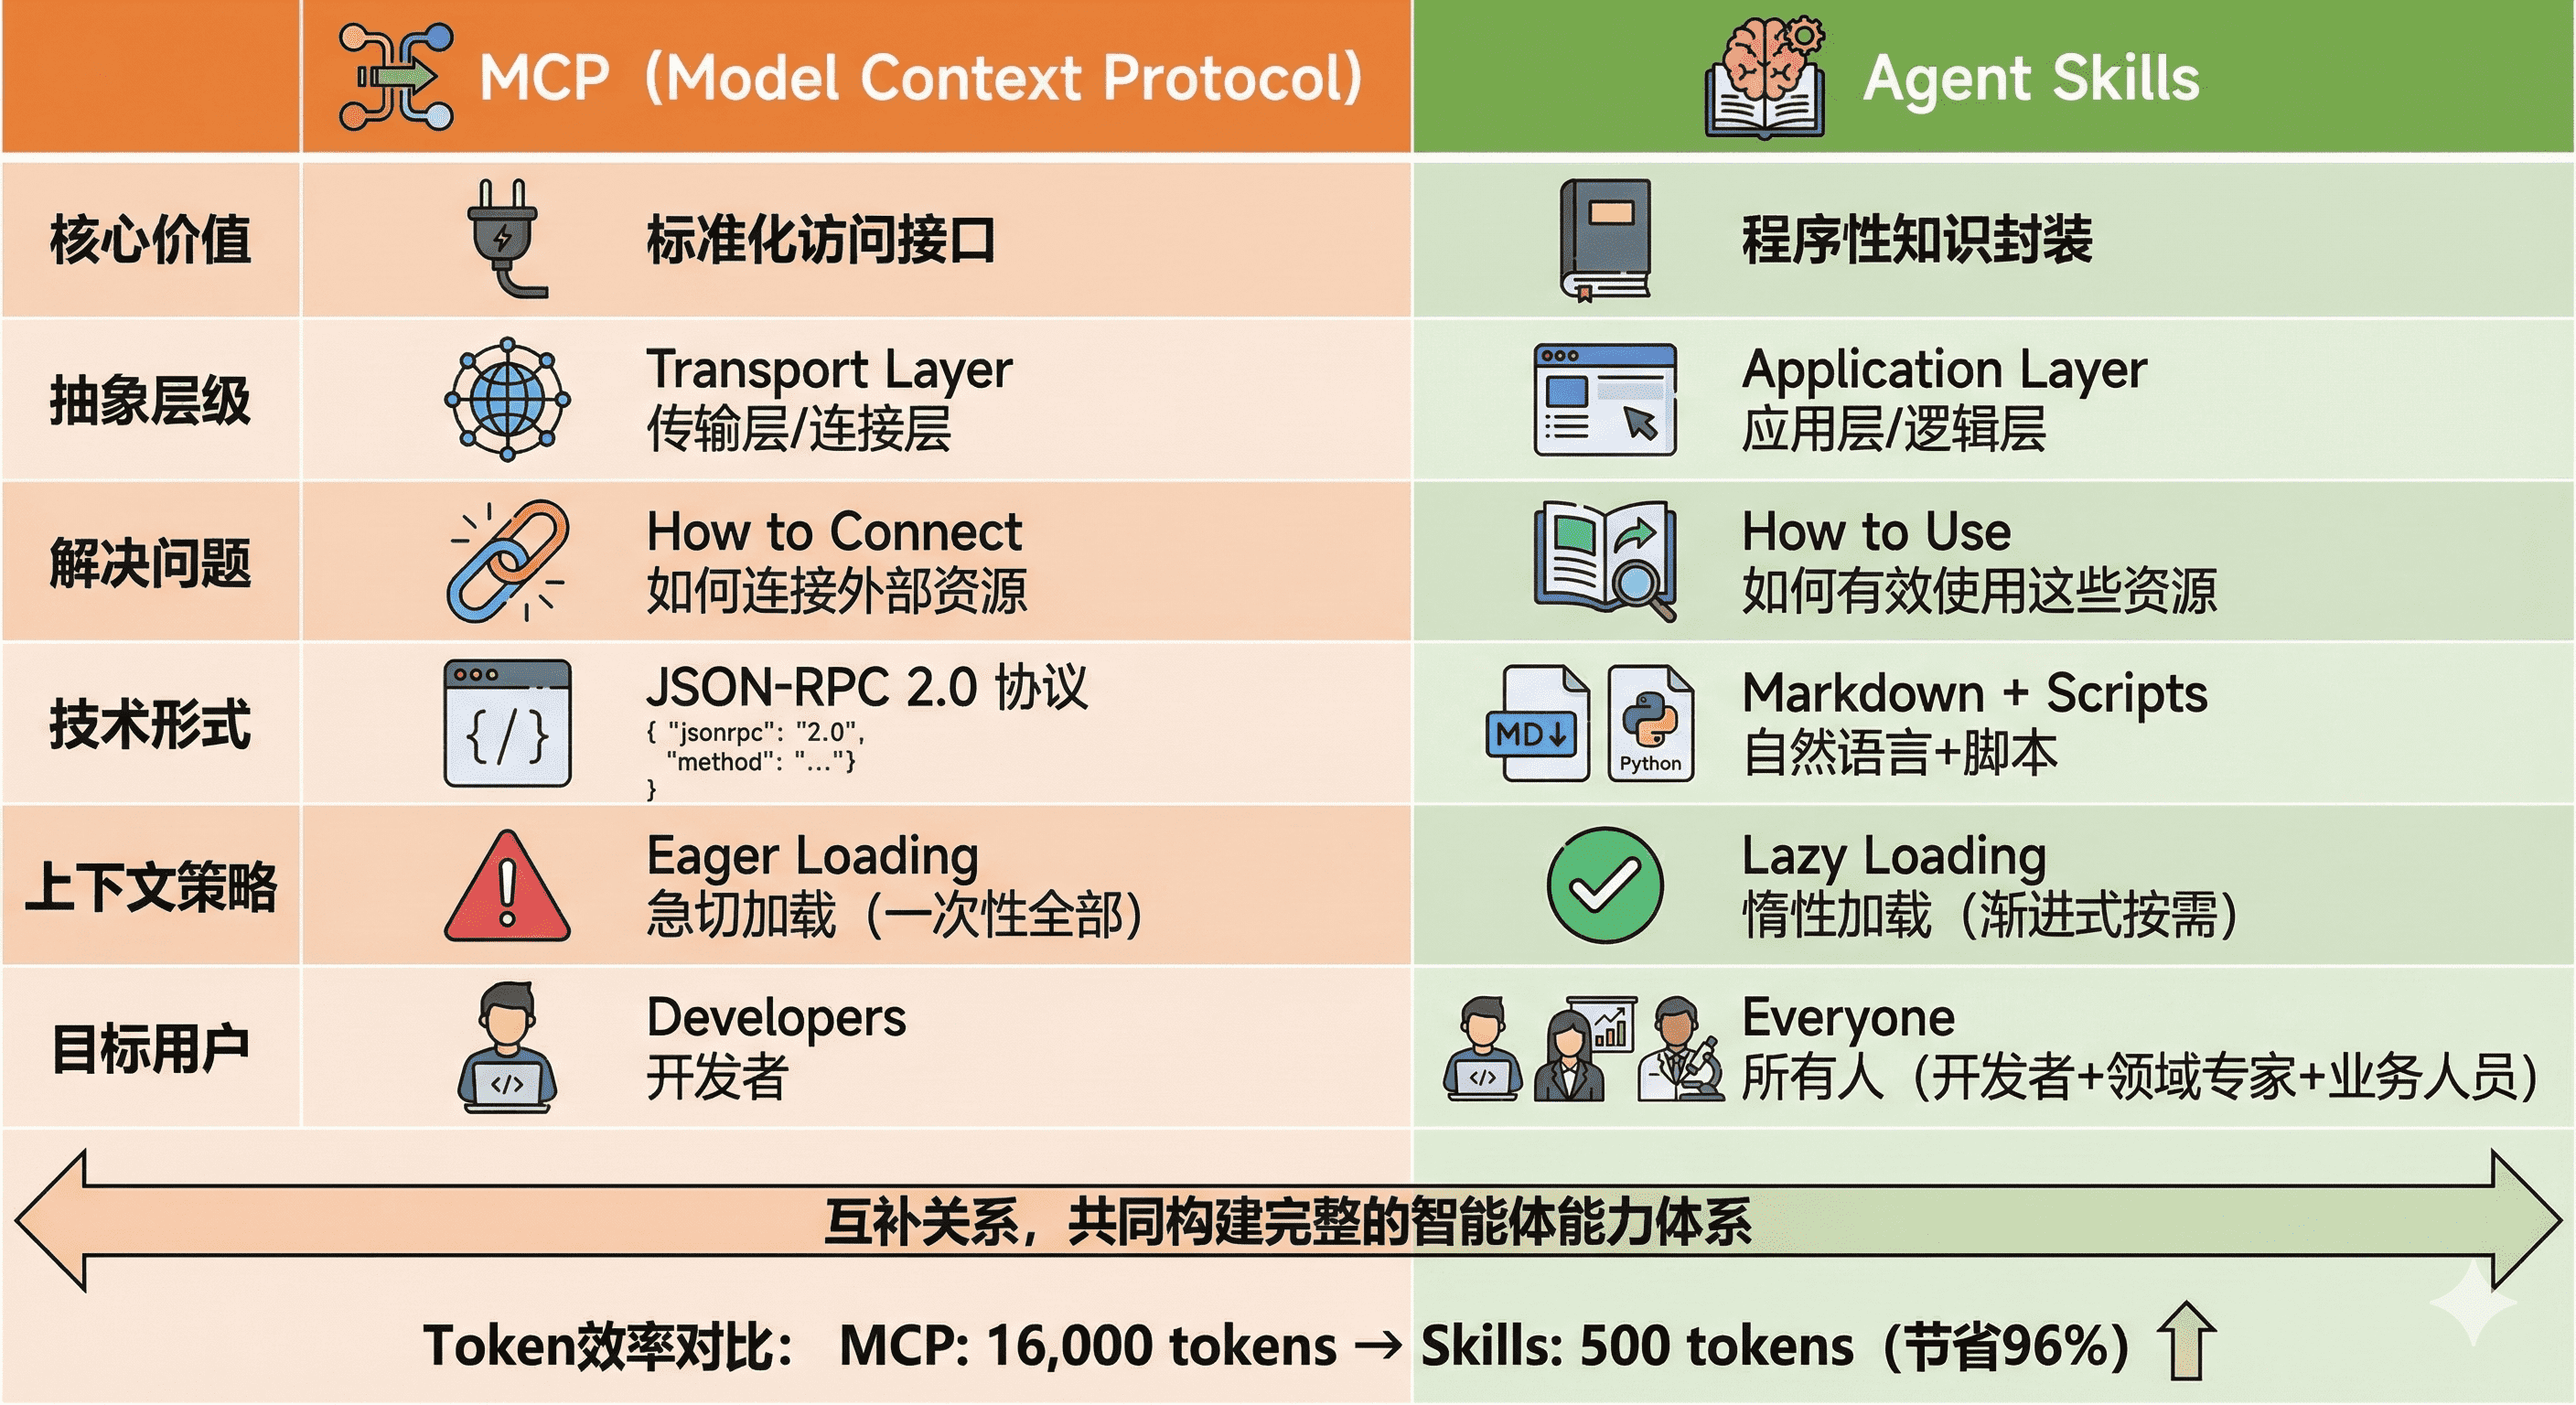
关键洞察:
-
分层架构是必然趋势:随着智能体系统复杂度增加,"连接层"和"知识层"的分离是不可避免的
-
上下文效率是核心矛盾:Skills 的渐进式披露机制将 token 消耗降低 90% 以上,这是其最大的技术优势
-
领域知识的民主化:Skills 让非开发者也能贡献智能体能力,这将极大拓展 AI 应用的边界
-
混合架构是最佳实践:在企业级应用中,MCP 提供基础设施连接,Skills 提供业务逻辑,两者结合才能构建高效、可维护的智能体系统
实践建议:
- 对于外部服务连接(数据库、API、云服务),优先使用 MCP
- 对于复杂工作流(多步骤任务、领域专业知识),优先使用 Skills
- 在上下文受限的场景(长对话、大量工具),使用 Skills 进行渐进式管理
- 构建企业级智能体时,采用 MCP + Skills 的分层架构
通过本章的学习,你应该能够:
- 理解 Agent Skills 和 MCP 的本质区别与协作关系
- 掌握 Skills 的渐进式披露机制及其优势
- 编写高质量的 SKILL.md 文件
- 在实际项目中合理选择和组合两种技术
- 构建分层清晰、高效可维护的智能体系统
智能体技术仍在快速演进中。MCP 已成为连接层的事实标准,Skills 的理念也在影响整个行业。掌握这两种技术,将帮助你在 AI 浪潮中构建更强大、更实用的智能体应用。
参考资料
- Anthropic Agent Skills 官方文档:https://docs.anthropic.com/en/docs/agent-skills
- Anthropic Skills GitHub 仓库:https://github.com/anthropics/skills
- Model Context Protocol 规范:https://modelcontextprotocol.io/
- Anthropic 博客:Improving Frontend Design Through Skills:https://www.claude.com/blog/improving-frontend-design-through-skills
- 第十章:智能体通信协议(hello-agents)
如何写出好的 Skill
什么是 Skill?怎么写好skill? 我们沿着 skill-creator 的设计思路,找到答案。 本篇文章的目标是:读完它,就了解了写skill的最佳实践。
一、什么是 Skill?
1.1 定义
Skill 是一个文件夹,里面装着指令文档、参考资料、可执行脚本等资源。AI 拿到它,就能胜任一项原本不会的特定工作。
比如一个 pdf-editor 技能文件夹里,可能有一份"怎么处理 PDF"的操作指令、一个旋转 PDF 的 Python 脚本、一份 API 参考文档——AI 不需要从外部再找任何东西,这个文件夹里全有了。
这个概念不限于某一个产品。无论是 Codex、Claude 还是其他 AI Agent,skill 的本质都一样。你可以把它理解为 AI 的一个能力插件——插上去,AI 就多了一项专长;拔掉,AI 还是原来那个通用助手。
1.2 最小形态
一个 skill 最少只需要一个文件:
my-skill/
└── SKILL.md
SKILL.md 的结构很简单——上半部分告诉 AI"什么时候用我",下半部分告诉 AI"具体怎么做":
---
name: my-skill # ← 上半部分:元数据
description: >- # AI 靠这里决定要不要激活这个技能
当用户需要做某件事时,使用这个技能。
---
下半部分:操作指令 # ← AI 激活技能后才会读到这里
按照以下步骤执行...
上半部分叫 frontmatter(--- 之间的 YAML),包含 name 和 description 两个字段。AI 在每次对话开始时都会扫描所有已安装技能的 frontmatter,靠 description 来判断"这个技能和当前请求相关吗"——这是技能被触发的唯一依据。
下半部分叫 body(Markdown 正文),是技能被激活之后才加载的操作指令。如果技能没被触发,AI 永远不会读到这里。
1.3 完整结构
当一个技能变复杂时,单靠一个 SKILL.md 就不够了。
比如你要做一个"PDF 处理"技能:SKILL.md 里写了处理流程,但旋转 PDF 的代码每次都一样,每次让 AI 重写既浪费时间又可能出错——不如直接放一个写好的 Python 脚本。再比如"前端项目生成器"技能:每次都要一套 HTML/React 的样板文件,不如直接放一个模板目录让 AI 拷贝出来改。
所以完整的 skill 目录可以包含这些东西:
skill-name/
├── SKILL.md # [必需] 入口文件:frontmatter + body
├── agents/
│ └── openai.yaml # [推荐] 技能的"名片"
├── scripts/ # [可选] 可执行脚本
├── references/ # [可选] 参考文档
└── assets/ # [可选] 产出物模板
逐个说明:
-
SKILL.md — 唯一必需的文件,前面已经介绍过
-
scripts/ — 写好的程序,AI 不需要读懂它,直接调用 shell 执行就行。比如
scripts/rotate_pdf.py,AI 只要跑python rotate_pdf.py input.pdf 90就能旋转 PDF,不用每次重新写旋转逻辑。适合那些结果必须精确、不能让 AI 自由发挥的操作 -
references/ — AI 在工作过程中需要查阅的参考资料。比如一个"BigQuery 查询"技能,AI 要知道公司有哪些表、每个表有什么字段,这些信息放在
references/schema.md里,AI 需要时再读取。和 scripts 的区别是:references 是给 AI 读的,scripts 是给 AI 执行的 -
assets/ — 不是给 AI 看的,而是直接用在最终产出里的文件。比如一个"前端项目生成器"技能,
assets/frontend-template/里放着一套 HTML/React 样板代码,AI 直接把这套模板拷贝出来,在上面修改。再比如assets/logo.png是公司 logo,AI 生成网页时直接引用它。AI 不需要"读懂"一张 logo 图片,只需要知道它在哪、什么时候放进去 -
agents/openai.yaml — 技能的"名片"。很多 AI 产品会在界面上展示一个技能列表,让用户选择或搜索。这个文件里存的就是列表中显示的名称、简介、图标等信息。它不影响 AI 的行为,纯粹是给产品界面用的
二、你是在给人写指令,还是在给 AI 写指令?
知道了 skill 是什么,下一步就是写一个。但大多数人第一次写出来的 skill 都有同一个问题。
看一个例子。假设你要做一个"代码审查"技能,你可能会这样写:
---
name: code-review
description: 代码审查技能
---
# Code Review Skill
## 背景
本技能基于团队多年的代码审查经验总结而成,旨在提升代码质量和团队协作效率。
## 审查原则
- 保持专业、建设性的语气
- 关注代码质量而非个人风格
- 平衡严格性和灵活性
## 使用方式
当用户提交代码时,对代码进行全面审查,给出改进建议。注意保持友好和鼓励的态度。
## 版本记录
- v1.0: 初始版本
- v1.1: 增加了对 Python 的支持
如果这是一份给人看的团队文档,它写得不错——有背景、有原则、有使用方式,甚至还有版本记录。
但 skill 的读者是 AI。用这个视角重新审视:
- "基于团队多年经验总结" — AI 不关心这个技能是怎么来的,它只需要知道现在该怎么做
- "保持专业、建设性的语气" — 人类读了能 get 到一个大致的感觉,但 AI 会把"专业"和"建设性"展开成无数种组合,每次输出都不一样
- "平衡严格性和灵活性" — 人类经验丰富的审查者知道什么时候严格什么时候灵活,但 AI 没有这个直觉,这句话等于没说
- "全面审查,给出改进建议" — 这是对人类审查者的期望,但 AI 需要的是:先检查什么?再检查什么?什么问题必须指出?什么问题可以忽略?
- "版本记录" — AI 每次被唤醒都是全新的,v1.0 还是 v1.1 对它没有意义
- description 只写了"代码审查技能" — AI 靠 description 判断是否触发,"代码审查技能"五个字太模糊:用户说"帮我看看这段代码"要触发吗?"这个函数性能怎么样"要触发吗?
每一条单独看都不是"错",但它们都是写给人看的。问题不在于写得不够多,而在于写错了对象。
那正确的写法是什么样的?我们来看一个现成的答案——codex的skill-creator。它是一个"创建 skill 的 skill",它自己的 SKILL.md 就是一份关于"如何给 AI 写指令"的最佳实践。
三、skill-creator 的整体框架
打开 skill-creator 的 SKILL.md(约 370 行),在深入任何细节之前,我们先建立对它的整体认知。
skill-creator 要解决的问题只有一个:怎么在有限的上下文窗口里,给 AI 最有效的指令?
围绕这个问题,它给出了一套完整的设计体系,可以用三个层次来理解。
第一层:根本约束——简洁
AI 的上下文窗口是有限的,而且是共享的(系统提示、对话历史、所有已安装技能的元数据都在里面)。你的 skill 占得越多,留给其他用途的就越少。所以 skill-creator 的第一原则就是:每一句话都要值得它占用的 token。
第二层:两个设计维度
在"简洁"这个约束下,写 skill 时面临两个核心决策:
维度一:信息放在哪里?
不是所有信息都需要一开始就加载。skill-creator 设计了一个三级分层架构,让不同的信息在不同的时机进入上下文:
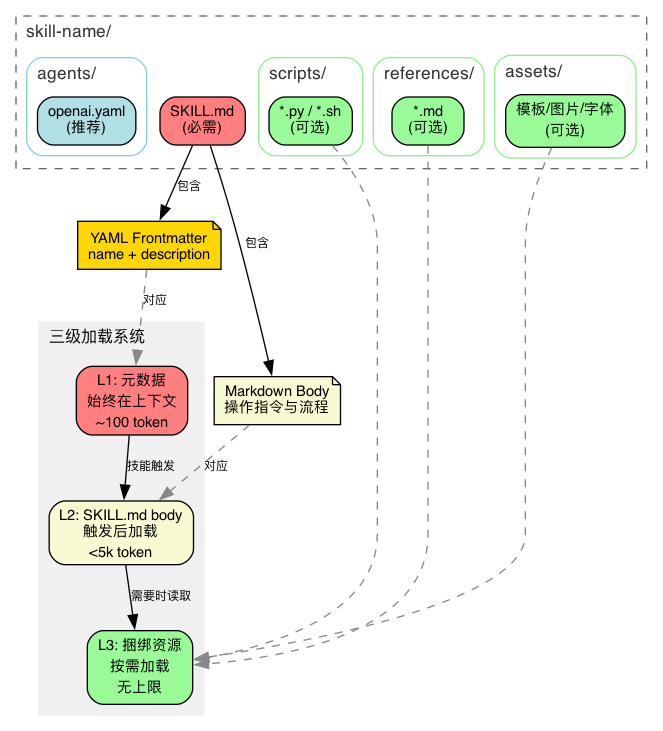
- L1(元数据):始终在上下文中,约 100 词——AI 靠它判断要不要激活这个技能
- L2(SKILL.md body):触发后才加载,控制在 5k 词以内——操作指令
- L3(scripts/references/assets):按需使用,无上限——其中 scripts 执行而不读入,零 token 成本
这解决了"怎么用最少的 token 承载最多的信息"。
维度二:给 AI 多大自由度?
不是所有任务都适合让 AI 自由发挥。
举个例子:让 AI 写一篇技术博客,十个人写出十种风格都可以——你只需要给方向,具体怎么写让 AI 自己决定。这就是高自由度。
但让 AI 生成一个 YAML 配置文件就不一样了。比如 skill-creator 要生成的 openai.yaml,里面有个 short_description 字段,要求 25-64 个字符、首字母大写、不能有引号。AI 写成 65 个字符?不行,产品界面会截断。写成 24 个字符?不行,校验不通过。漏了首字母大写?界面显示不一致。这种任务差一个字符就出问题,你不能让 AI 自由发挥,必须用脚本来锁死格式——这就是低自由度。这类任务叫"脆弱操作":不是说它复杂,而是说它做对只有一种方式,做错有一百种方式。
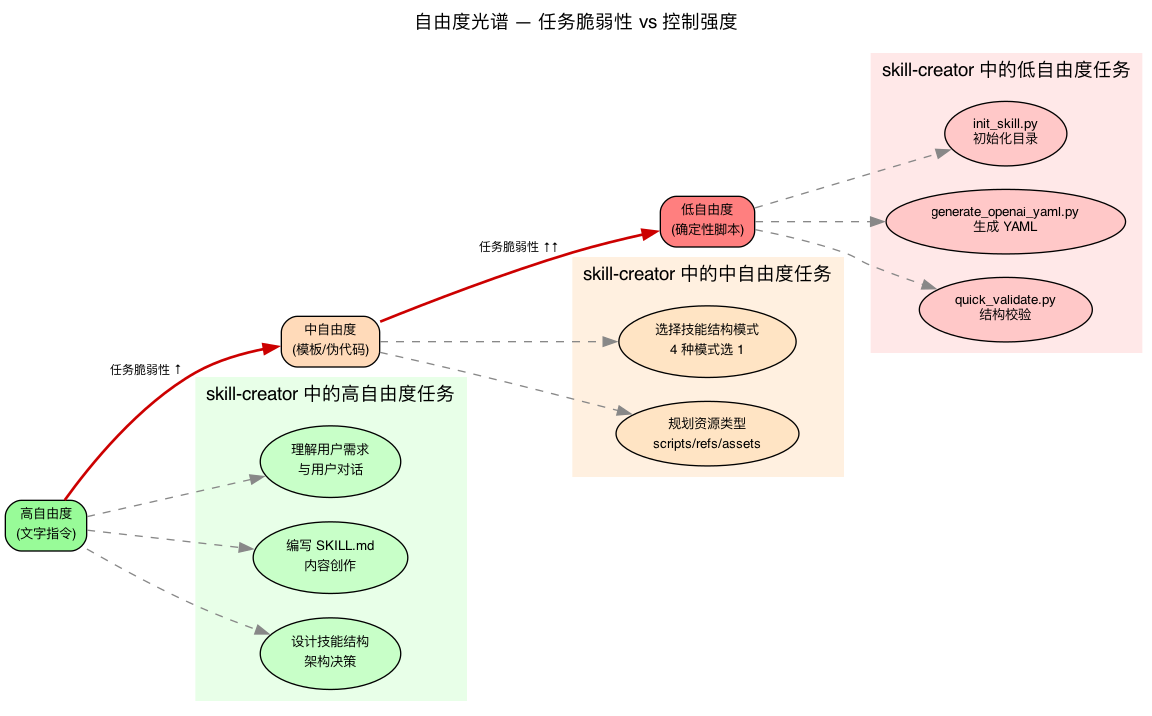

这解决了"怎么在 AI 的灵活性和输出的可靠性之间取得平衡"。
第三层:落地流程
有了原则和架构,skill-creator 最后给出了一个六步创建流程,把设计思想变成可执行的操作步骤:
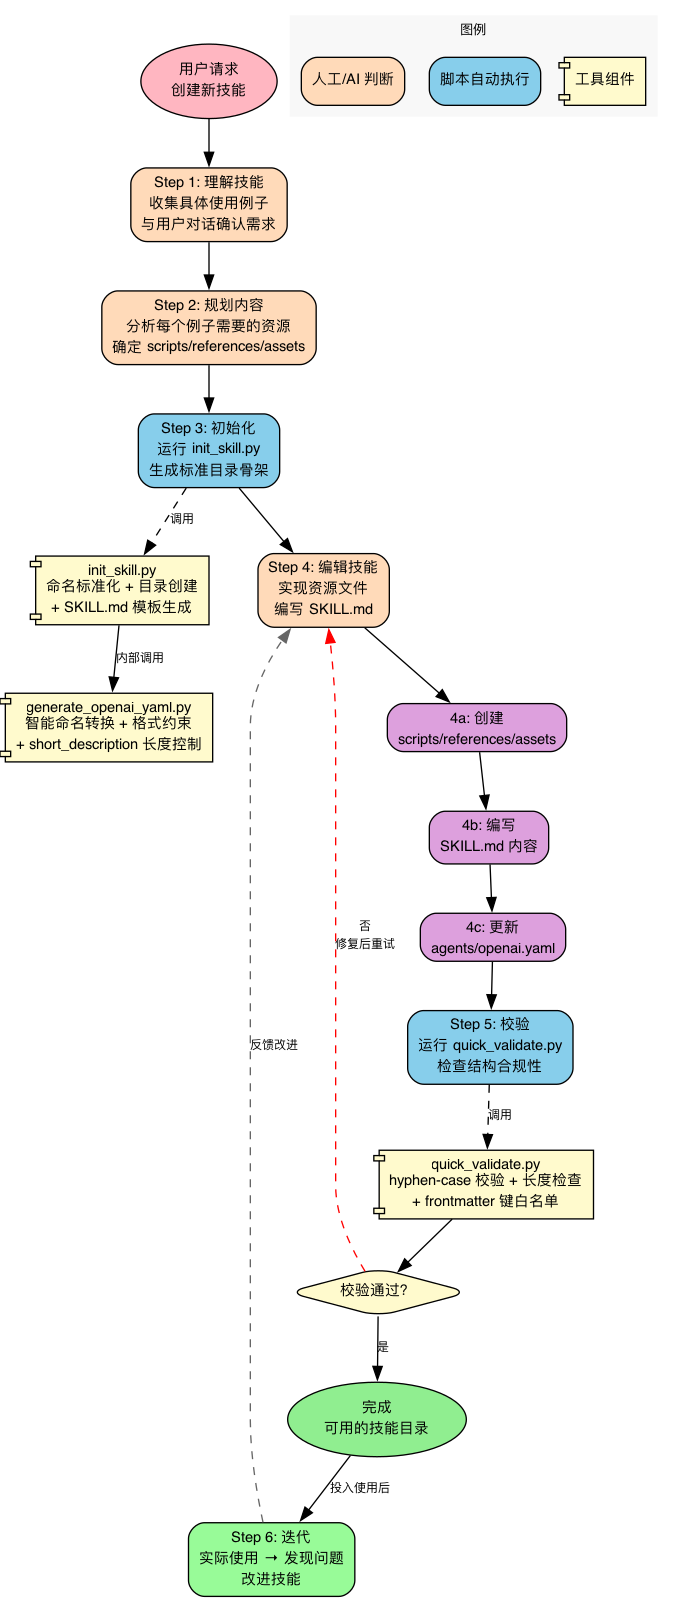
理解→规划→初始化→编辑→校验→迭代。其中脚本贯穿流程,形成确定性的质量保障链:
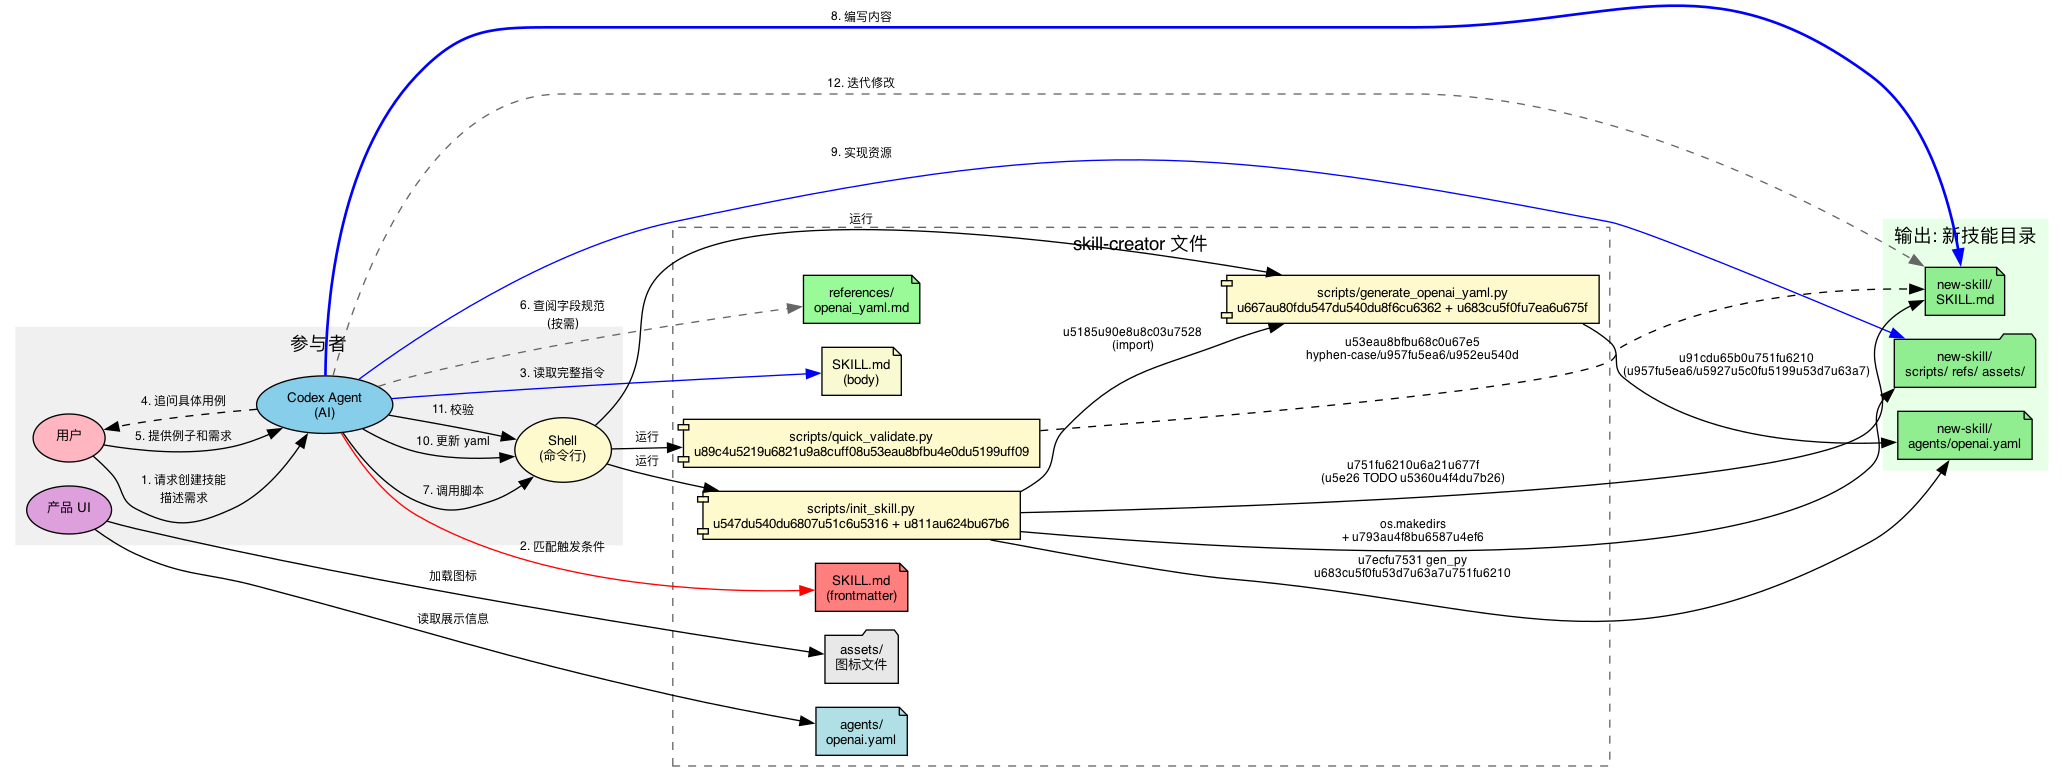
框架总览
三个层次的关系:
简洁(根本约束) → 第四章
├── 信息放在哪里? → 三级分层架构 → 第五章
├── 给 AI 多大自由度? → 自由度光谱与脚本 → 第六章
└── 怎么落地? → 六步创建流程 → 第七章
接下来的每一章都在这个框架内展开。
四、根本约束:简洁
框架位置:第一层
4.1 核心约束
AI 的上下文窗口就像一张工作台——它同一时间能摊开的资料是有限的。而这张工作台上已经放着不少东西了:系统自己的规则、用户之前说过的话、所有已安装技能的简介。你的 skill 一旦被激活,它的内容也要摊上去。工作台就这么大,你占得越多,留给其他东西的空间就越少。
所以 skill-creator 把这一点写成了第一条原则:
The context window is a public good. Skills share the context window with everything else Codex needs: system prompt, conversation history, other Skills' metadata, and the actual user request.
既然工作台空间有限,那写 skill 时怎么判断一段内容该不该放进去?skill-creator 给了一个前提假设:AI 本身已经很聪明了,你只需要补充它不知道的东西。
Default assumption: Codex is already very smart. Only add context Codex doesn't already have.
基于这个假设,每写一段内容之前问自己两个问题:
- "AI 是不是已经知道这个了?" — 比如"Python 的 for 循环怎么写",AI 当然知道,不用教
- "这段内容值不值得占用工作台上的空间?" — 一段 200 字的解释,能不能用一个 10 行的代码示例替代?
实操推论:用简洁的示例代替冗长的解释。一个好的代码示例胜过三段文字描述。
4.2 什么不该放进 Skill?
Skill-creator 明确列出了禁止清单:
A skill should only contain essential files that directly support its functionality. Do NOT create extraneous documentation or auxiliary files.
不该有的文件:
- README.md
- INSTALLATION_GUIDE.md
- QUICK_REFERENCE.md
- CHANGELOG.md
The skill should only contain the information needed for an AI agent to do the job at hand. It should not contain auxiliary context about the process that went into creating it, setup and testing procedures, user-facing documentation, etc. Creating additional documentation files just adds clutter and confusion.
原因很简单:skill 的读者是 AI,不是人类开发者。AI 不需要安装指南、更新日志、快速参考这些"人类辅助文档"。每一个多余的文件都是噪音。
4.3 写约束时,"不做什么"比"做什么"更精确
简洁不只是"少写",还包括"写对"。看一个例子。
当 skill-creator 创建 laotou-thought-style(一种写作风格技能)时,它没有写:
请用温暖、克制、有洞察力的语气写作。
这种正面描述看起来清晰,但对 AI 来说,"温暖"的程度、"克制"和"有洞察力"之间的平衡——全是模糊空间。
它做的是写了一份反模式清单(references/anti-patterns.md):
| 不要这样做 | 症状 | 怎么改 |
|---|---|---|
| 角色堆砌 | 连续出现多个名字和对白 | 保留一个冲突场景,补抽象提炼 |
| 只有鸡汤没有动作 | 全文"要坚持、要努力" | 改为今天可做的一小步 |
| 直接大道理 | 开头就讲规律 | 先铺生活场景 |
| 收尾太猛 | 结尾"必须改变!" | 换成"慢慢来""就好" |
| 过度绝对化 | "永远""一定" | 加限定词"多数时候""往往" |
每一条都是具体的、可检测的、有明确修正方案的。
背后的原理:
"做什么" → 描述一个无限大的可行域 → AI 在里面随机游走
"不做什么" → 在可行域上画边界 → AI 的行为空间被收窄到你想要的范围
skill-creator 自身也遵循了这个原则——它的 SKILL.md 用了很大篇幅说"什么不该写"(What to Not Include in a Skill),而不是泛泛地说"写好内容"。
当你写完 SKILL.md,做一次"反转测试":每一条正面指导,能不能改写成"不要做X"的形式?如果可以,改写后通常更精确。
4.4 统一使用祈使语气
skill-creator 要求 SKILL.md 的正文统一使用祈使语气/不定式(Always use imperative/infinitive form)。这不是美学偏好,而是为了减少歧义——祈使句天然就是指令。
五、设计维度一:信息放在哪里?
框架位置:第二层 — 维度一
在第三章的框架总览中,我们已经看到了三级分层架构的全貌。这一章展开讲它的细节。
5.1 三级渐进式加载
skill-creator 原文对三个层级的定义:
- Metadata (name + description) - Always in context (~100 words)
- SKILL.md body - When skill triggers (<5k words)
- Bundled resources - As needed by Codex (Unlimited because scripts can be executed without reading into context window)
| 层级 | 内容 | 何时在上下文中 | token 成本 |
|---|---|---|---|
| L1 | frontmatter(name + description) | 始终 | ~100 词 |
| L2 | SKILL.md body | 触发后加载 | <5k 词 |
| L3 | scripts/ references/ assets/ | 按需加载 | 无上限 |
这本质上是一个信息熵管理系统:
- L1 是过滤器 — 从几十个已安装技能中筛选出当前需要的那一个。description 不精确 → 误触发或漏触发
- L2 是操作手册 — 触发后告诉 AI 该怎么做。太长 → 注意力被稀释。body 控制在 500 行以内
- L3 是工具箱 — 只在需要时打开。其中 scripts/ 最高效——执行而不读入,零 token 成本
5.2 Frontmatter:触发机制的全部来源
Frontmatter 只有两个必需字段:name 和 description。但 description 的写法至关重要:
This is the primary triggering mechanism for your skill, and helps Codex understand when to use the skill.
skill-creator 自己的 description 是这样写的:
description: Guide for creating effective skills. This skill should be used when
users want to create a new skill (or update an existing skill) that extends
Codex's capabilities with specialized knowledge, workflows, or tool integrations.
它不只说"做什么"(creating effective skills),还说"什么时候用"(when users want to create a new skill or update an existing skill)。
关键规则:
- 把所有"when to use"信息放在 description 里,不要放在 body 里。body 是触发后才加载的,那时候 Codex 已经决定用了,"什么时候用"的信息已经迟了
- 不要在 frontmatter 中放
name和description以外的字段(license、allowed-tools、metadata除外)
一个好的 description 示例(docx 技能):
"Comprehensive document creation, editing, and analysis with support for tracked changes, comments, formatting preservation, and text extraction. Use when Codex needs to work with professional documents (.docx files) for: (1) Creating new documents, (2) Modifying or editing content, (3) Working with tracked changes, (4) Adding comments, or any other document tasks"
5.3 四种捆绑资源的本质区别
理解这四种资源的区别,是理解整个 skill 系统的关键:
Scripts(scripts/)
可执行代码(Python/Bash 等),用于需要确定性可靠性或反复重写的任务。
- 什么时候需要:同样的代码每次都要重新写,或者需要确定性的可靠输出
- 举例:
scripts/rotate_pdf.py用于 PDF 旋转任务 - 核心优势:token 高效、确定性、可以执行而不读入上下文窗口
- 注意:脚本有时仍需要被 Codex 读取,用于修补或环境适配
References(references/)
文档和参考材料,在需要时加载到上下文中,辅助 Codex 的思考过程。
- 什么时候需要:Codex 在工作时需要参考的详细文档
- 举例:
references/finance.md(财务 schema)、references/api_docs.md(API 规范)、references/policies.md(公司政策) - 用途:数据库 schema、API 文档、领域知识、公司政策、详细工作流指南
- 核心优势:保持 SKILL.md 精炼,只在 Codex 判断需要时才加载
- 最佳实践:如果文件很大(>10k 词),在 SKILL.md 中包含 grep 搜索模式
- 避免重复:信息应该只存在于 SKILL.md 或 references 文件中,不能两边都有。详细信息优先放 references,SKILL.md 只保留核心流程指令和工作流指导
Assets(assets/)
不是用来加载到上下文中的文件,而是直接用在 Codex 产出物中的资源。
- 什么时候需要:技能需要在最终输出中使用的文件
- 举例:
assets/logo.png(品牌素材)、assets/slides.pptx(PPT 模板)、assets/frontend-template/(HTML/React 样板)、assets/font.ttf(字体) - 用途:模板、图片、图标、样板代码、字体、示例文档——这些会被复制或修改
- 核心优势:将输出资源与文档分离,Codex 可以使用它们而无需读入上下文
Agents 元数据(agents/openai.yaml)(推荐)
面向 UI 的元数据,不给 AI 读,给产品前端读:
- 包含
display_name、short_description、default_prompt等字段 - 通过脚本
generate_openai_yaml.py确定性生成,而不是手写 - 更新 SKILL.md 后要检查
agents/openai.yaml是否还匹配,过期了就重新生成 - 详细字段定义见
references/openai_yaml.md
5.4 渐进式披露的三种实战模式
Skill-creator 给出了三种把内容拆分到 references 的具体模式:
Pattern 1:高层指南 + 参考文件
# PDF Processing
## Quick start
Extract text with pdfplumber:
[code example]
## Advanced features
- **Form filling**: See [FORMS.md](FORMS.md) for complete guide
- **API reference**: See [REFERENCE.md](REFERENCE.md) for all methods
- **Examples**: See [EXAMPLES.md](EXAMPLES.md) for common patterns
Codex 只在需要时才加载 FORMS.md、REFERENCE.md 或 EXAMPLES.md。
Pattern 2:按领域组织
多领域/多变体技能,按领域拆分避免加载无关内容:
bigquery-skill/
├── SKILL.md (overview and navigation)
└── reference/
├── finance.md (revenue, billing metrics)
├── sales.md (opportunities, pipeline)
├── product.md (API usage, features)
└── marketing.md (campaigns, attribution)
用户问销售指标时,Codex 只读 sales.md。
同样适用于多框架/多变体场景:
cloud-deploy/
├── SKILL.md (workflow + provider selection)
└── references/
├── aws.md (AWS deployment patterns)
├── gcp.md (GCP deployment patterns)
└── azure.md (Azure deployment patterns)
Pattern 3:条件性细节
基础功能直接展示,高级功能按需链接:
# DOCX Processing
## Creating documents
Use docx-js for new documents. See [DOCX-JS.md](DOCX-JS.md).
## Editing documents
For simple edits, modify the XML directly.
**For tracked changes**: See [REDLINING.md](REDLINING.md)
**For OOXML details**: See [OOXML.md](OOXML.md)
5.5 两条重要的避坑指南
- 避免深层嵌套引用 — 所有 reference 文件应该从 SKILL.md 直接链接,不要 A → B → C 式嵌套
- 长文件加目录 — 超过 100 行的 reference 文件要在顶部加 TOC,方便 Codex 预览全貌
5.6 常见的层错位
| 错误 | 后果 | 修正 |
|---|---|---|
| 触发条件放在 body 里 | body 是触发后才加载的,晚了 | 放 frontmatter description |
| "When to Use This Skill" 写在 body | 同上,Codex 已经决定用了才看到 | 移到 description |
| 参考细节塞进 SKILL.md | body 膨胀,信息密度下降 | 拆到 references/,body 只放引用链接 |
| 确定性操作写成文字指令 | AI 每次重新理解,可能出错 | 封装成 scripts/,执行不读入 |
| references 互相引用 | AI 需要多跳获取信息 | 所有 references 从 SKILL.md 直接链接 |
| SKILL.md 和 references 内容重复 | 浪费 token,更新时可能不一致 | 信息只在一处存在 |
六、设计维度二:给 AI 多大自由度?
框架位置:第二层 — 维度二
知道了信息该放在哪里、该怎么约束,下一个问题是:AI 做什么,脚本做什么?
AI 非常擅长理解语义、生成文本、做创造性工作。但它不擅长精确格式控制、长度约束、命名规范——这些"脆弱操作"。
6.1 三个自由度档位
Skill-creator 用一个自由度光谱来处理这种不均匀性(见第三章框架图):
Think of Codex as exploring a path: a narrow bridge with cliffs needs specific guardrails (low freedom), while an open field allows many routes (high freedom).
高自由度(文字指令):多种方法都可行时,决策依赖上下文,用启发式引导。
中自由度(伪代码/带参数的脚本):有最佳实践但允许变通,配置影响行为。
低自由度(具体脚本,少量参数):操作脆弱容易出错,一致性至关重要,必须遵循特定序列。
核心逻辑:
任务越脆弱(容易出错) → 自由度越低 → 用脚本锁死
任务越灵活(多种方案都对) → 自由度越高 → 用文字引导
6.2 skill-creator 自身的自由度分配
| 任务 | 自由度 | 实现方式 |
|---|---|---|
| 理解用户需求并提问 | 高 | SKILL.md 文字指导 |
| 规划技能内容结构 | 中 | 模板 + 选择题式模式推荐 |
| 初始化目录结构 | 低 | init_skill.py 脚本 |
| 生成 openai.yaml | 低 | generate_openai_yaml.py 脚本 |
| 编写 SKILL.md 内容 | 高 | 原则指导 + 写作建议 |
| 校验最终结果 | 低 | quick_validate.py 脚本 |
6.3 两个方向的错误
错误 1:给脆弱任务太多自由度
# 错误
请生成一个 openai.yaml 文件,包含 display_name 和 short_description。
# 后果:short_description 可能超过 64 字符限制,大小写可能不一致
Skill-creator 的做法:用 generate_openai_yaml.py 脚本锁死格式。AI 只提供参数值,脚本保证输出合规。
错误 2:给创造性任务太多约束
# 错误
第一段必须以"昨天"开头,第二段必须包含"本质上",最后一段以"慢慢来"结尾。
# 后果:生成的文本像填词游戏
Skill-creator 的做法:给结构比例(场景层 ≤30%,原理层 30-40%),但不锁定具体用词。
6.4 判断标准
两个问题:
- 做错了后果多严重? — 越严重 → 越低自由度
- 有多少种"正确"的做法? — 越多 → 越高自由度
6.5 低自由度的实现:skill-creator 的三个脚本
理解了自由度光谱,就能理解 skill-creator 为什么有三个脚本——它们就是"低自由度"的具体实现(脚本间的交互关系见第三章框架图)。
init_skill.py(输入保障,398 行)
初始化新技能目录的脚手架工具,类似 create-react-app 之于 React 项目:
scripts/init_skill.py <skill-name> --path <output-directory> \
[--resources scripts,references,assets] [--examples] \
[--interface key=value]
核心功能:
- 创建技能目录
- 生成带 TODO 占位符的 SKILL.md 模板(TODO 是给 Codex 看的"填空题")
- 调用
generate_openai_yaml.py生成agents/openai.yaml(通过--interface key=value传入 AI 生成的 display_name、short_description、default_prompt) - 可选创建
scripts/、references/、assets/子目录 - 可选添加示例文件(
--examples) - 内置
normalize_skill_name()自动把任意用户输入标准化为 hyphen-case
使用示例:
scripts/init_skill.py my-skill --path skills/public
scripts/init_skill.py my-skill --path skills/public --resources scripts,references
scripts/init_skill.py my-skill --path skills/public --resources scripts --examples
generate_openai_yaml.py(格式保障,226 行)
专门负责生成和更新 agents/openai.yaml:
- 从 SKILL.md 的 frontmatter 读取技能名
- 自动将 hyphen-case 转为 Title Case(
my-cool-skill→My Cool Skill) - 内置缩写词典(GH、MCP、API 等保持大写)和品牌词典(openai → OpenAI)
- 自动生成 25-64 字符的
short_description - 支持
--interface key=value覆盖任意字段
scripts/generate_openai_yaml.py <path/to/skill-folder> --interface key=value
quick_validate.py(输出保障,102 行)
技能创建后的"质检员":
scripts/quick_validate.py <path/to/skill-folder>
校验内容:
- SKILL.md 是否存在
- YAML frontmatter 格式是否合法
name:是否为 hyphen-case,≤ 64 字符,无连续/首尾连字符description:是否存在,无尖括号,≤ 1024 字符- 只允许
name、description、license、allowed-tools、metadata这 5 个 frontmatter 键
6.6 质量保障链
三个脚本形成了一条确定性保障链,夹住中间的创造性步骤:
init_skill.py(输入保障)
命名标准化 + 目录结构创建 + 模板生成
→ 确保起点正确
↓
AI 创造性编写(高自由度)
→ SKILL.md 内容、references、自定义 scripts
↓
quick_validate.py(输出保障)
frontmatter 格式 + 命名规范 + 长度约束校验
→ 确保终点合规
关键洞察:脚本是"执行而不读入"的——零 token 成本。你可以把任意复杂的确定性逻辑封装进脚本,而不用担心它占用上下文。这就是为什么 skill-creator 把命名转换(缩写词典、品牌词典)、长度约束(25-64 字符)、格式校验这些细碎但脆弱的操作全部交给了脚本。
6.7 什么该封装成脚本?
每次执行结果必须一样 → 脚本
涉及精确格式/长度约束 → 脚本
涉及命名规范转换 → 脚本
需要校验规则匹配 → 脚本
同样的代码每次都要重新写 → 脚本
需要理解上下文 → 文字指令
有多种合理做法 → 文字指令
需要创造性判断 → 文字指令
脚本有时仍需要被 Codex 读取(用于修补或环境适配),但大多数时候它们是"执行而不读入"的。
七、落地:六步创建流程
框架位置:第三层
有了前面的原则和架构,skill-creator 最后给出了一个六步创建流程,把设计思想变成可执行的操作步骤(见第三章框架图)。
7.0 命名规范
在开始之前,先确定命名:
- 只用小写字母、数字和连字符;把用户提供的名称标准化为 hyphen-case(如 "Plan Mode" →
plan-mode) - 名称 ≤ 64 字符
- 优先用简短的、动词开头的短语来描述动作
- 需要时用工具名做命名空间(如
gh-address-comments、linear-address-issue) - 技能文件夹名与技能名完全一致
7.1 Step 1:理解技能——用具体例子建立共识
Skip this step only when the skill's usage patterns are already clearly understood.
要创建一个有效的 skill,必须先清楚理解具体的使用例子。这些理解可以来自用户提供的例子,也可以来自生成的、经用户验证的例子。
以构建 image-editor 技能为例,可以问用户:
- "image-editor 技能应该支持什么功能?编辑、旋转,还有其他吗?"
- "能给一些使用这个技能的例子吗?"
- "我能想到用户会说'去掉这张照片的红眼'或'旋转这张图片'。还有其他使用方式吗?"
- "用户会说什么话来触发这个技能?"
注意:不要一次问太多问题。先问最重要的,然后根据需要跟进。
完成标志:对技能应该支持的功能有了清晰的认识。
7.2 Step 2:规划可复用的技能内容
对每个具体例子做两个分析:
- 如果从零开始做这件事,需要什么?
- 其中哪些会被反复使用?
反复使用的东西 → 封装成 scripts/references/assets。
skill-creator 给了三个典型分析案例:
案例 1:pdf-editor 技能(用户问"帮我旋转这个 PDF")
- 旋转 PDF 每次都要重写同样的代码
- → 封装为
scripts/rotate_pdf.py
案例 2:frontend-webapp-builder 技能(用户问"帮我做一个 todo app"或"做一个步数追踪仪表盘")
- 写前端 webapp 每次都需要同样的 HTML/React 样板代码
- → 封装为
assets/hello-world/模板目录
案例 3:big-query 技能(用户问"今天有多少用户登录了?")
- 查询 BigQuery 每次都要重新发现表的 schema 和关系
- → 封装为
references/schema.md
完成标志:列出了所有要包含的可复用资源清单(scripts、references、assets)。
7.3 Step 3:初始化技能
When creating a new skill from scratch, always run the
init_skill.pyscript.
这里用的是"always"——不是"建议",是"总是"。原因:
- 脚本生成的目录结构保证符合规范
- 模板中的 TODO 提醒确保不遗漏必需字段
agents/openai.yaml的格式约束(字段长度、引号规则)靠手写容易出错
这是低自由度原则的直接应用:初始化是一个脆弱操作,用脚本消除出错可能。
初始化后:
- 定制 SKILL.md 并根据需要添加资源
- 如果用了
--examples,替换或删除占位符文件
7.4 Step 4:编辑技能
这是最核心的步骤,分两阶段:
阶段一:先实现可复用资源
从 Step 2 规划的资源开始:实现 scripts/、references/、assets/ 文件。
注意:
- 这一步可能需要用户输入(比如
brand-guidelines技能需要用户提供品牌素材) - 新增的脚本必须通过实际运行来测试,确保无 bug 且输出符合预期
- 如果有很多类似的脚本,只需测试代表性样本来建立信心
- 如果用了
--examples,删除不需要的占位符文件。只创建真正需要的资源目录
阶段二:更新 SKILL.md
Frontmatter 写法:
---
name: skill-name
description: >-
描述技能做什么 + 具体什么时候用。
把所有 "when to use" 信息放这里,不要放在 body 里。
---
Body 写法:
写给另一个 Codex 实例的操作指令。包含对 Codex 有帮助但不显而易见的信息:程序性知识、领域细节、可复用资源的使用方式。
统一使用祈使语气/不定式。
7.5 Step 5:校验技能
scripts/quick_validate.py <path/to/skill-folder>
校验 YAML frontmatter 格式、必需字段、命名规则。不通过就修复后重新运行。
7.6 Step 6:迭代
After testing the skill, users may request improvements. Often this happens right after using the skill, with fresh context of how the skill performed.
迭代工作流:
- 在真实任务上使用技能
- 发现吃力或低效的地方
- 找出 SKILL.md 或捆绑资源该如何更新
- 实施变更并重新测试
好的 skill 不是一次写成的。skill-creator 创建的 laotou-thought-style 技能,在第一次生成后就迭代了 openai.yaml 的 short_description 和 default_prompt——从泛泛的描述变为更精确的操作指令。
八、总结
回到最初的问题:怎么写出好的 skill?
回顾整个框架:
根本约束:简洁(第四章)
├── 信息放在哪里? → 三级分层,按需加载(第五章)
├── 给 AI 多大自由度? → 脆弱操作脚本锁死,创造性工作文字引导(第六章)
└── 怎么落地? → 六步流程:理解→规划→初始化→编辑→校验→迭代(第七章)
Skill是给 AI 写指令,而不是给人。用最少的 token,在正确的层级,给 AI 最精准的约束,让它在边界内自由发挥。